Blog Pengembangan Web
Token robots.txt Baru untuk Menolak Pelatihan AI di Situs
Daftar isi· 8 bagian
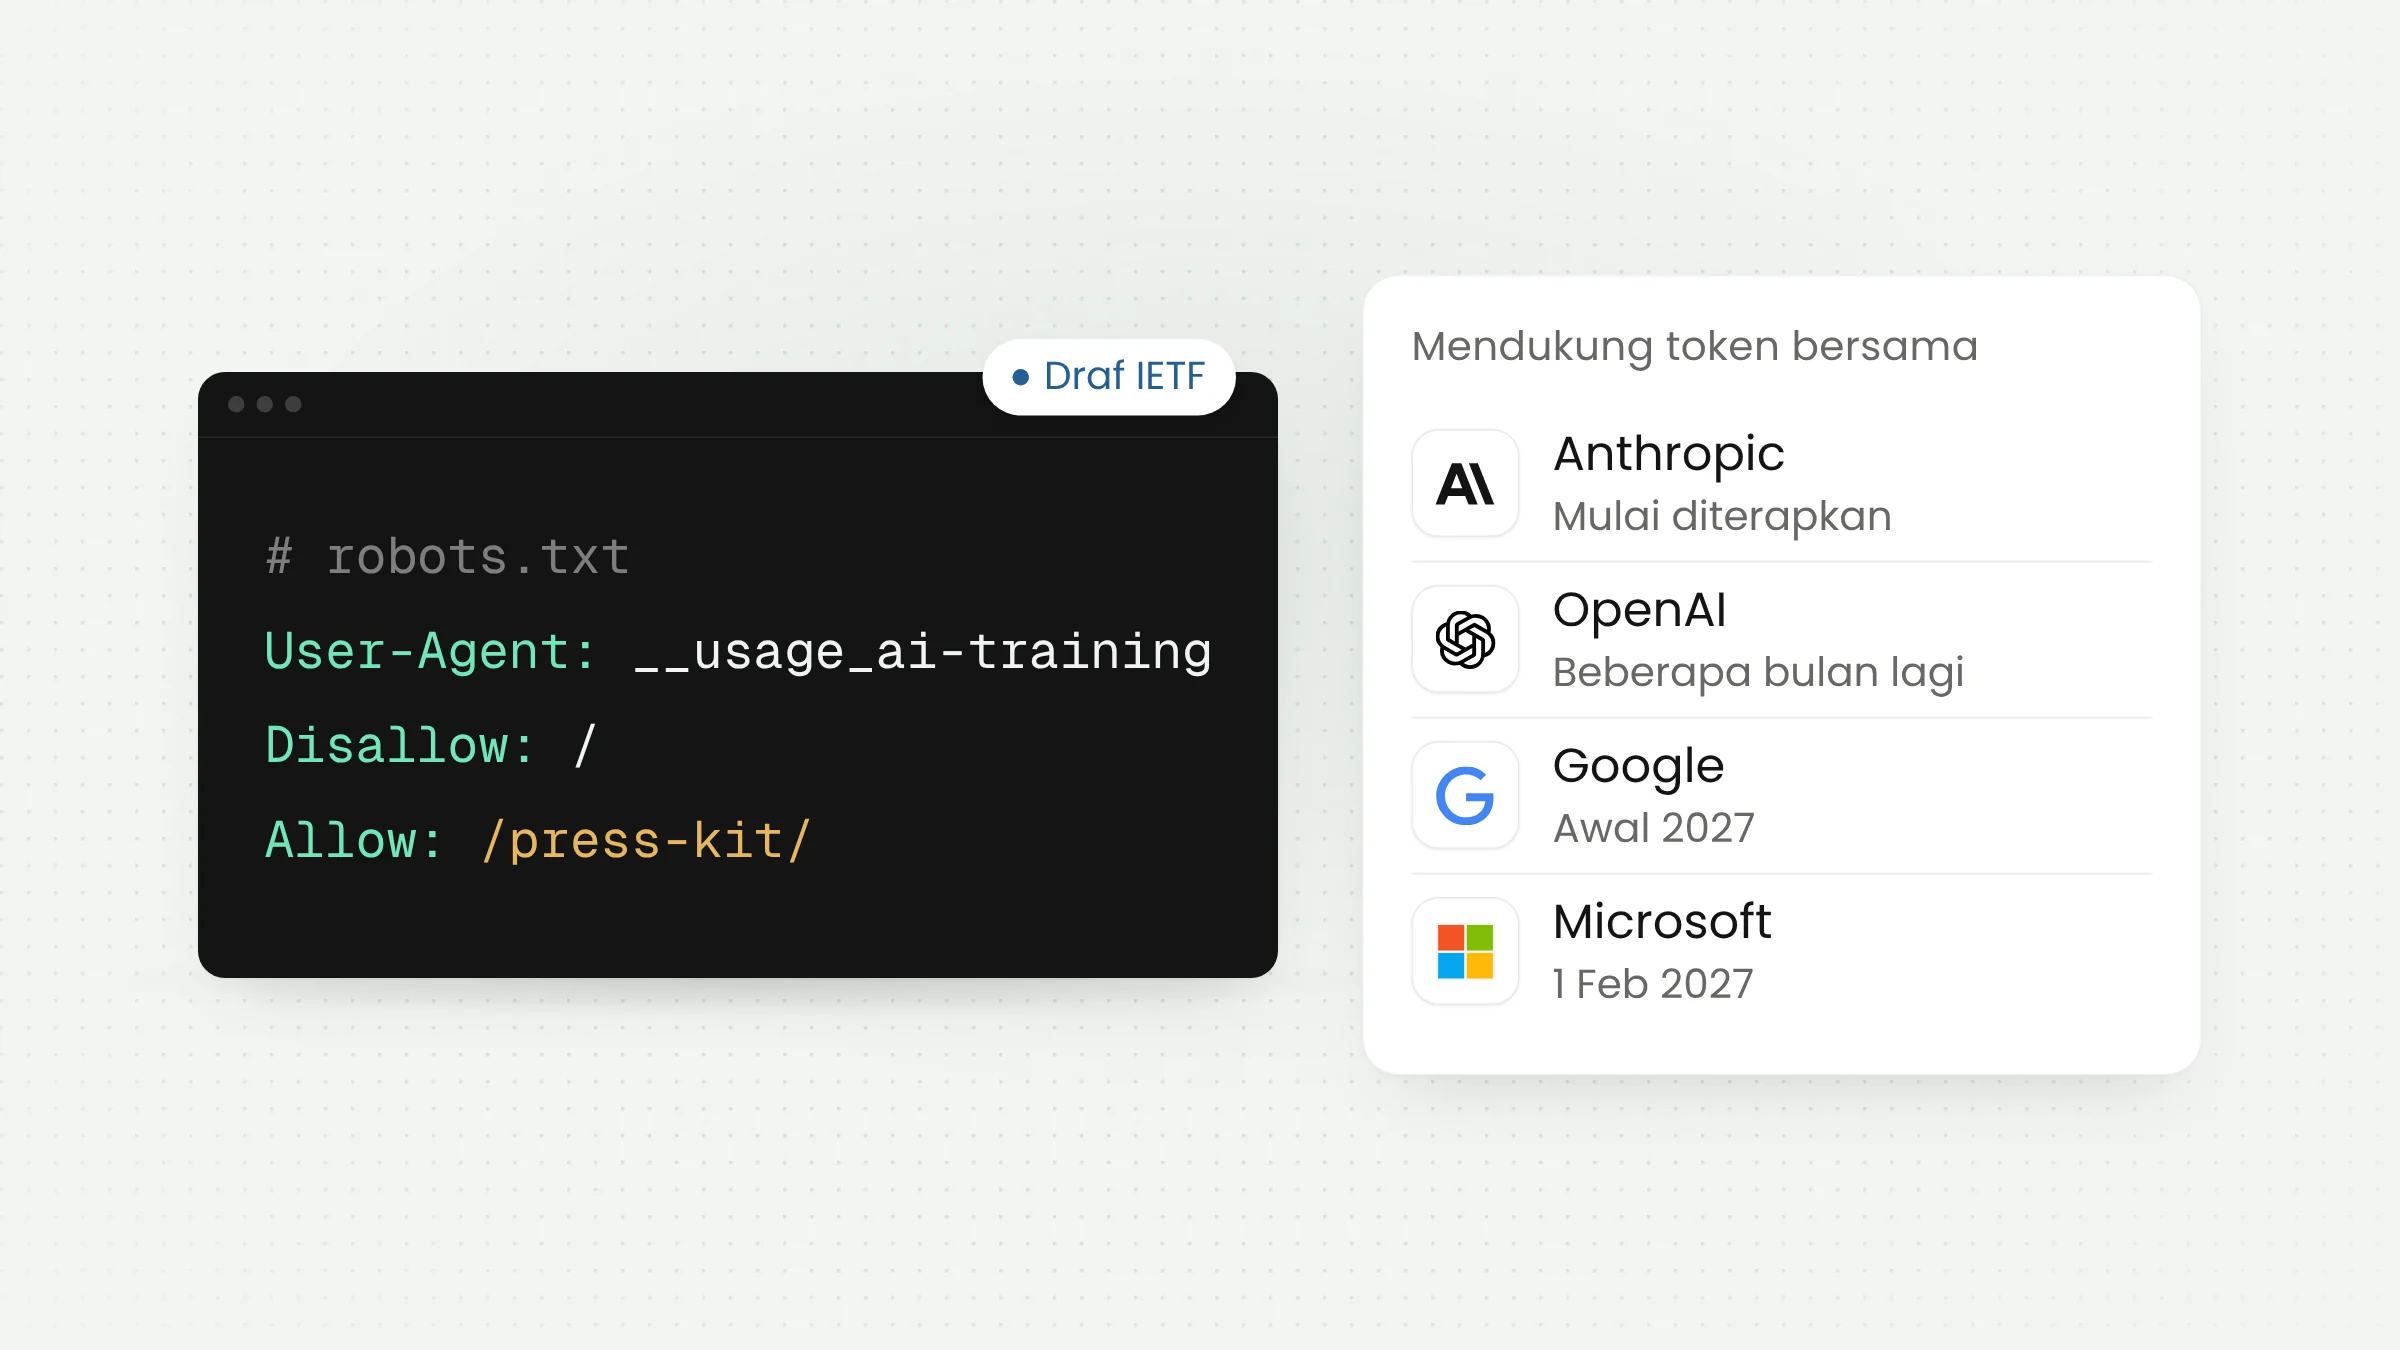
Pengelola situs akan dapat menolak pemakaian kontennya untuk pelatihan AI cukup dengan satu kelompok aturan di robots.txt. Pada 30 Oktober 2026, Google, Microsoft, OpenAI, dan Anthropic menyatakan akan mendukung token bersama __usage_ai-training, yang diusulkan lewat draf di Internet Engineering Task Force (IETF).
Satu token untuk banyak penyedia AI
Selama ini, situs yang tidak ingin kontennya dipakai melatih model AI harus menulis aturan terpisah untuk setiap perayap (crawler). Ada GPTBot milik OpenAI, Google-Extended milik Google, ClaudeBot milik Anthropic, dan nama lain yang terus bertambah. Daftar itu mudah tertinggal ketika penyedia baru muncul atau penyedia lama mengganti nama perayapnya.
Usulan baru ini menggantinya dengan satu nama yang sama untuk semua penyedia. Nama itu disebut policy token, yaitu nama yang ditulis di baris User-Agent seperti nama perayap biasa, tetapi isinya menyatakan sikap pemilik situs terhadap satu jenis pemakaian konten. Contoh dari drafnya seperti berikut.
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Tiga baris itu berarti pemilik situs menolak seluruh kontennya dipakai untuk pelatihan AI, kecuali isi folder /press-kit/. Aturan jalur, urutan prioritas, dan struktur kelompok mengikuti robots.txt yang sudah dikenal sejak lama, sehingga tim web tidak perlu mempelajari format baru.
Mekanisme ini dijelaskan dalam draf Machine-Readable Training Preference Signal yang ditulis Kevin Kelley dari Anthropic. Draf bertanggal 30 Oktober 2026 itu berlaku sampai 3 Mei 2027 dan dibahas di milis kelompok kerja AI Preferences IETF.
Status draf dan batas cakupannya
Draf ini masih berstatus usulan perorangan. Situs datatracker IETF mencatat bahwa draf perorangan belum didukung IETF dan belum punya kedudukan resmi sebagai standar. Isinya masih dapat berubah, diganti, atau ditarik.
Cakupannya juga sempit. Draf ini memakai definisi pelatihan AI dari dokumen kosakata kelompok kerja yang sama, yaitu memakai konten untuk mengubah parameter yang dipelajari sebuah model AI generatif. Pelatihan model yang hanya dipakai untuk klasifikasi, pemeringkatan, atau penilaian tidak termasuk, walaupun model itu sebenarnya mampu menghasilkan teks atau gambar.
Ada beberapa ketentuan teknis yang perlu dipahami tim web:
- Kelompok wildcard
User-Agent: *tidak dihitung sebagai sikap terhadap pelatihan AI. Situs yang hanya punya aturan wildcard dianggap belum menyatakan apa pun. - Token ini tidak mengatur perayapan. Perayap tetap membaca aturan untuk nama perayapnya sendiri, misalnya GPTBot atau ClaudeBot. Penyedia boleh memakai token ini untuk memutuskan tidak mengambil halaman, tetapi drafnya tidak mewajibkan hal itu.
- Sikap yang berlaku untuk sebuah halaman adalah isi robots.txt pada saat halaman itu diambil.
- Perjanjian pribadi antara pemilik situs dan penyedia AI dapat mengesampingkan sikap yang tertulis di robots.txt.
Ketentuan ketiga menjelaskan batas yang disorot beberapa media, termasuk The Next Web: mengubah robots.txt hari ini tidak menarik konten yang sudah terkumpul atau sudah dipakai melatih model sebelumnya.
Jadwal Google, Microsoft, OpenAI, dan Anthropic
Keempat perusahaan menyatakan dukungan pada hari yang sama, tetapi jadwal penerapannya berbeda.
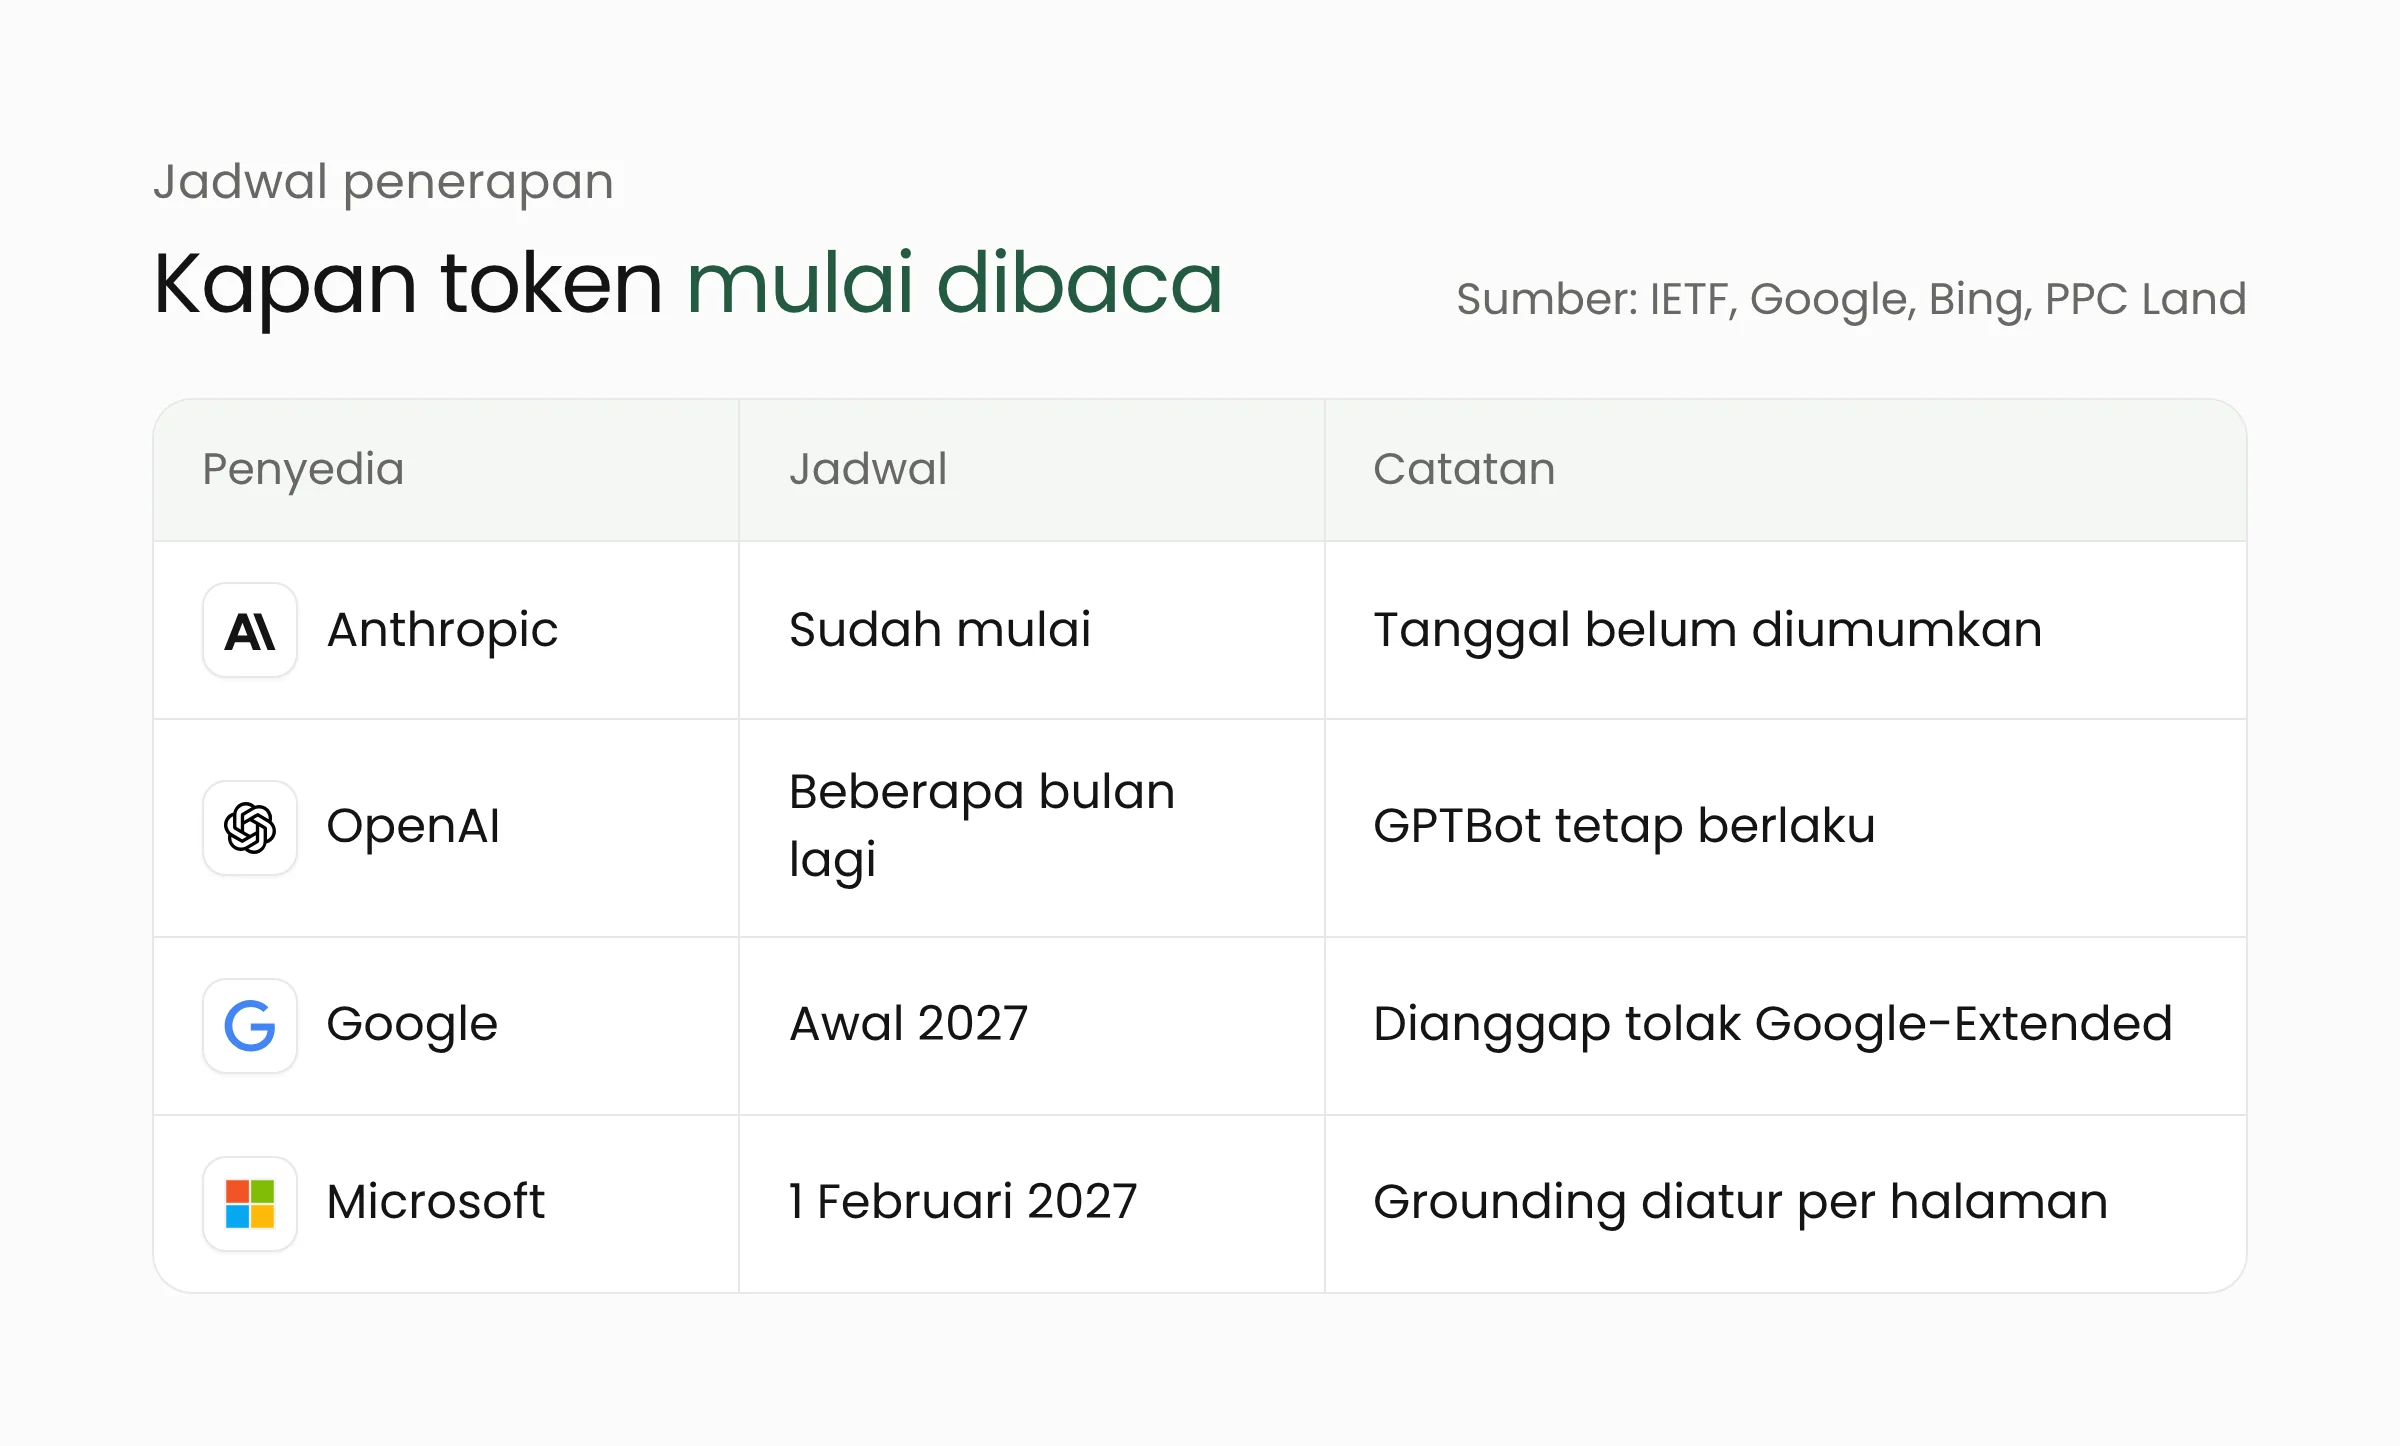
Anthropic. Dalam pesan ke milis IETF, Kevin Kelley menulis bahwa Anthropic sudah mulai menerapkan dukungan untuk draf ini, tetapi butuh waktu untuk menambahkannya di seluruh layanannya. Tanggal pastinya belum diumumkan. Dukungan ini melengkapi kontrol perayap Anthropic yang sudah ada, bukan menggantikannya.
OpenAI. Menurut laporan PPC Land, OpenAI menargetkan penerapan dalam beberapa bulan ke depan dan akan merilis detail teknisnya kemudian. OpenAI juga menyatakan bahwa token baru ini tidak menggantikan kontrol robots.txt yang sudah tersedia, termasuk GPTBot.
Google. Dalam blog Google Search Central, John Mueller menulis bahwa Google menargetkan dukungan pada 2027, sedangkan dokumentasi perayapnya menyebut awal 2027. Bila sebuah situs memakai token bersama untuk menolak pelatihan dan tidak menulis aturan khusus untuk Google-Extended, Google akan menganggapnya sama dengan menolak Google-Extended. Google juga menyebut usulan ini sejalan dengan Code of Practice untuk penyedia model AI serbaguna di bawah AI Act Uni Eropa.
Microsoft. Lewat Bing Blog, Microsoft menyatakan akan mulai menghormati preferensi AI Training dan AI Grounding pada 1 Februari 2027. Tag NoArchive dan NoCache yang selama ini dipakai sebagai sinyal tidak lagi dihitung untuk pelatihan maupun grounding mulai 1 Maret 2027.
Pelatihan dan grounding diatur terpisah
Microsoft membedakan dua pemakaian konten. Pelatihan berarti konten dipakai untuk membentuk model. Grounding berarti model membuka sebuah halaman untuk menjawab pertanyaan pengguna, misalnya ketika Copilot merangkum artikel lalu menautkan sumbernya.
Token robots.txt hanya mengatur pelatihan. Preferensi grounding di Bing ditulis per halaman, lewat tag meta atau header HTTP, dengan tiga pilihan: Allow, DisallowExtended, atau Disallow. Pilihan DisallowExtended membatasi grounding hanya pada layanan yang dijalankan Microsoft sendiri, sehingga layanan grounding yang dijual Microsoft ke pihak lain tidak dapat memakai halaman itu.
Contoh penulisannya di halaman adalah <meta name="Bingbot" content="ai-training:disallow"> untuk pelatihan dan ai-grounding:disallow untuk grounding. Header X-Robots-Tag dengan nilai serupa juga dapat dipakai.
Microsoft memberi masa peralihan. Mulai 15 Desember 2026, situs yang memakai NoArchive atau NoCache dapat mencatat preferensi grounding sementara di Bing Webmaster Tools. Preferensi sementara itu berakhir 30 September 2027.
Krishna Madhavan, Principal Product Manager Microsoft Bing, menulis, “Publishers should not have to choose between being discoverable in Bing and deciding how generative models use their work.” Microsoft menyatakan preferensi ini tidak mengubah kelayakan halaman untuk tampil di hasil pencarian Bing biasa. Namun, Microsoft juga mengingatkan bahwa menolak grounding akan mengurangi kemunculan merek di jawaban AI, dan pilihan apa pun tidak menjamin trafik atau pembayaran.
Apa artinya bagi pengelola situs?
Bagi media daring, kampus dengan repositori jurnal, instansi yang menerbitkan dokumen publik, atau toko daring dengan ribuan deskripsi produk, robots.txt kini perlu diperlakukan sebagai dokumen kebijakan. Keputusannya menyangkut dua hal: apakah konten boleh dipakai melatih model, dan apakah konten boleh muncul sebagai rujukan di jawaban AI.
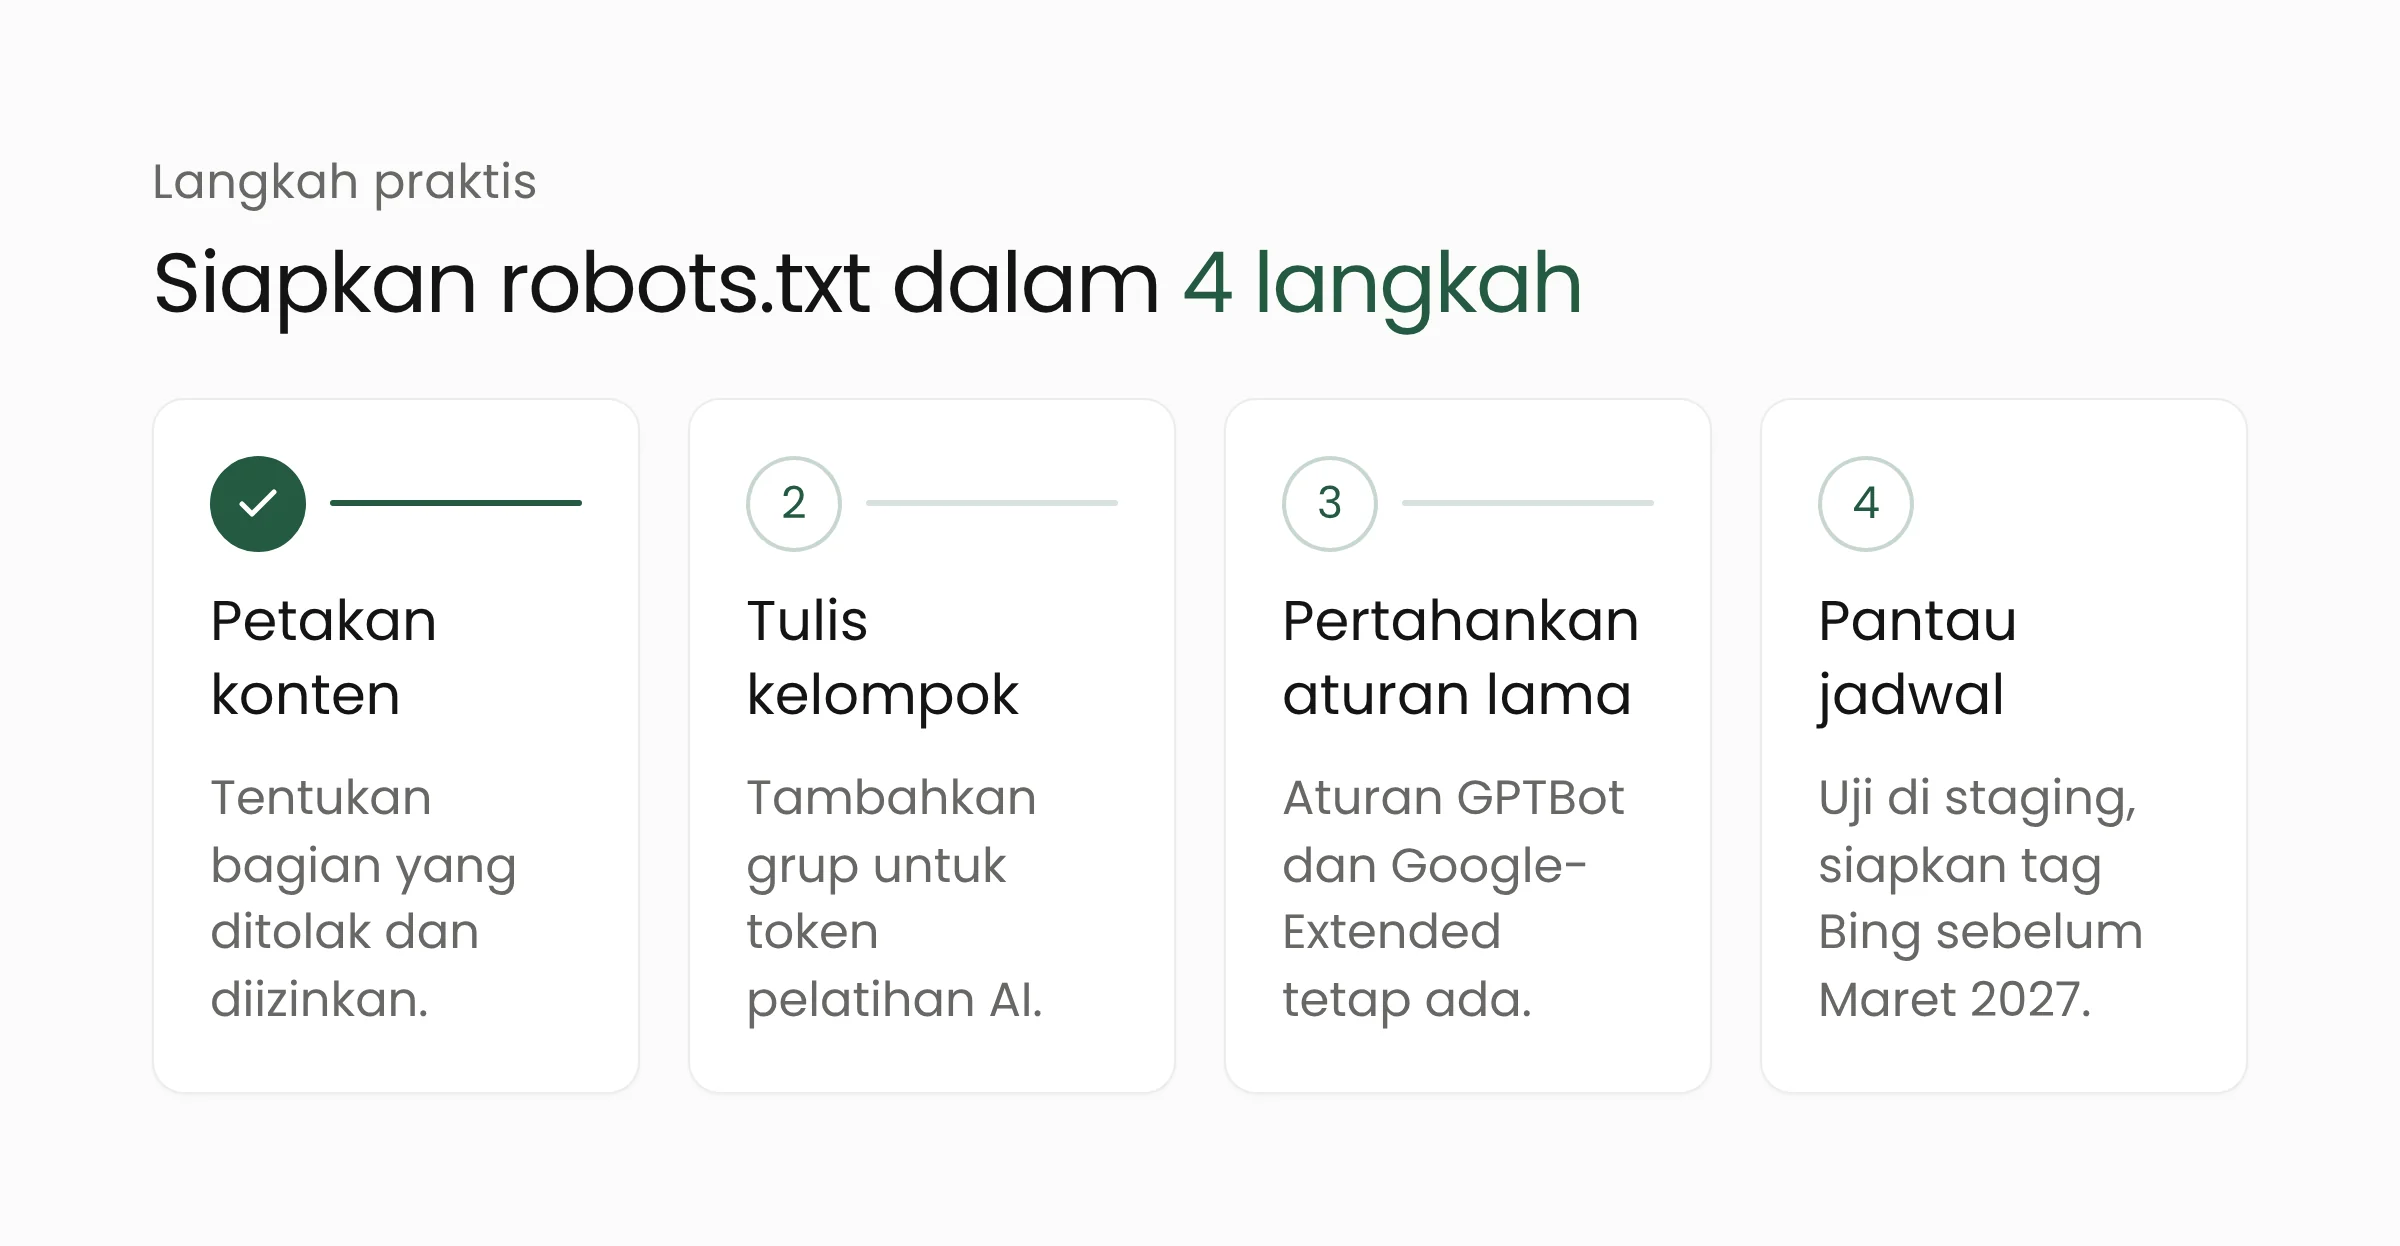
Langkah yang dapat disiapkan dari sekarang:
- Tentukan sikap per bagian situs. Berita dan artikel opini mungkin perlu ditolak untuk pelatihan, sementara halaman pers, profil lembaga, atau dokumentasi produk justru ingin dikenal model AI. Token ini mendukung aturan per jalur, jadi keputusan tidak harus berlaku untuk seluruh situs.
- Tulis kelompok aturan secara eksplisit. Tambahkan kelompok
User-Agent: __usage_ai-trainingdengan jalurDisallowatauAllowyang jelas. Aturan wildcard yang sudah ada tidak akan dibaca sebagai sikap terhadap pelatihan. - Pertahankan aturan lama. Selama Google, Microsoft, dan OpenAI belum menerapkan token ini, aturan untuk GPTBot, Google-Extended, dan ClaudeBot tetap menjadi satu-satunya cara yang sudah dibaca penyedia tersebut.
- Perhatikan efek Google-Extended. Menolak lewat token bersama tanpa aturan Google-Extended akan dianggap Google sebagai penolakan Google-Extended. Situs yang ingin tetap muncul di jawaban aplikasi Gemini perlu menulis aturan Google-Extended secara terpisah.
- Siapkan tag per halaman untuk Bing. Kalau situs ingin mengatur grounding di Copilot dan Bing, tag meta atau header perlu dipasang di templat halaman sebelum 1 Maret 2027.
Bagi situs yang dibangun dengan sistem manajemen konten, perubahan robots.txt sebaiknya diuji di lingkungan staging dulu. Kesalahan satu baris Disallow pada kelompok yang salah dapat mengeluarkan seluruh situs dari hasil pencarian. Tim yang mengelola banyak situs, misalnya portal kampus atau jaringan situs dinas, dapat memasukkan pengaturan ini ke templat bersama lewat layanan pengembangan web agar tidak diatur satu per satu. Untuk kampus dan sekolah, pertimbangan ini dapat masuk ke kebijakan repositori digital yang dibahas dalam solusi teknologi pendidikan.
Pengaturan visibilitas di mesin pencari bukan hal baru bagi pengelola komunitas daring. Kasus serupa pernah muncul ketika pesan Discord publik mulai tampil di pencarian web, dan pemilik server harus menentukan sendiri apa yang boleh diindeks.
Pertanyaan yang sering muncul
Apakah token ini membuat situs saya hilang dari Google Search atau Bing?
Tidak. Token __usage_ai-training hanya menyatakan sikap terhadap pelatihan AI. Microsoft menyatakan preferensi ini tidak mengubah kelayakan tampil di hasil pencarian Bing biasa. Dokumentasi Google juga menyebut Google-Extended tidak memengaruhi pemuatan situs di Google Search.
Apakah konten yang sudah dipakai melatih model bisa ditarik?
Tidak lewat mekanisme ini. Draf IETF menyatakan sikap yang berlaku adalah isi robots.txt pada saat halaman diambil. Konten yang sudah terkumpul sebelumnya tidak otomatis dihapus dari data pelatihan atau model yang sudah jadi.
Kapan token ini mulai berlaku?
Bergantung pada penyedianya. Anthropic sudah mulai menerapkan tanpa tanggal pasti, OpenAI menargetkan beberapa bulan ke depan, Google menargetkan awal 2027, dan Microsoft mulai 1 Februari 2027. Penyedia AI lain belum menyatakan komitmen.
Penutup
Token __usage_ai-training memberi pengelola situs satu tempat untuk menyatakan sikap terhadap pelatihan AI, walaupun statusnya masih draf dan penerapannya bertahap hingga 2027. Waktu beberapa bulan ke depan cukup untuk memetakan konten, menyusun kebijakan, dan menguji robots.txt baru. Kalau tim Anda ingin meninjau robots.txt, tag meta, dan templat situs sebelum jadwal Microsoft dan Google tiba, Merakit dapat membantu menyusunnya bersama tim Anda.
Sumber
- IETF Datatracker: draft-kelley-aipref-training-preference-signal-00, Machine-Readable Training Preference Signal (30 Oktober 2026)
- IETF ai-control: pengumuman draf oleh Kevin Kelley (30 Oktober 2026)
- Google Search Central Blog: dukungan kontrol pelatihan AI bersama (30 Oktober 2026)
- Bing Blog: Your content, your choice: clearer preferences for training and grounding (30 Oktober 2026)
- OpenAI: Making it easier for websites to express AI training preferences (30 Oktober 2026)
- PPC Land: Google, Microsoft, OpenAI and Anthropic back one AI training opt-out (31 Oktober 2026)
- The Next Web: Google, Microsoft, OpenAI and Anthropic back one AI training opt-out (31 Oktober 2026)