Blog Kecerdasan Buatan
MAI-DxO: Hasil Uji AI Diagnosis Microsoft dan Batasnya
Daftar isi· 7 bagian
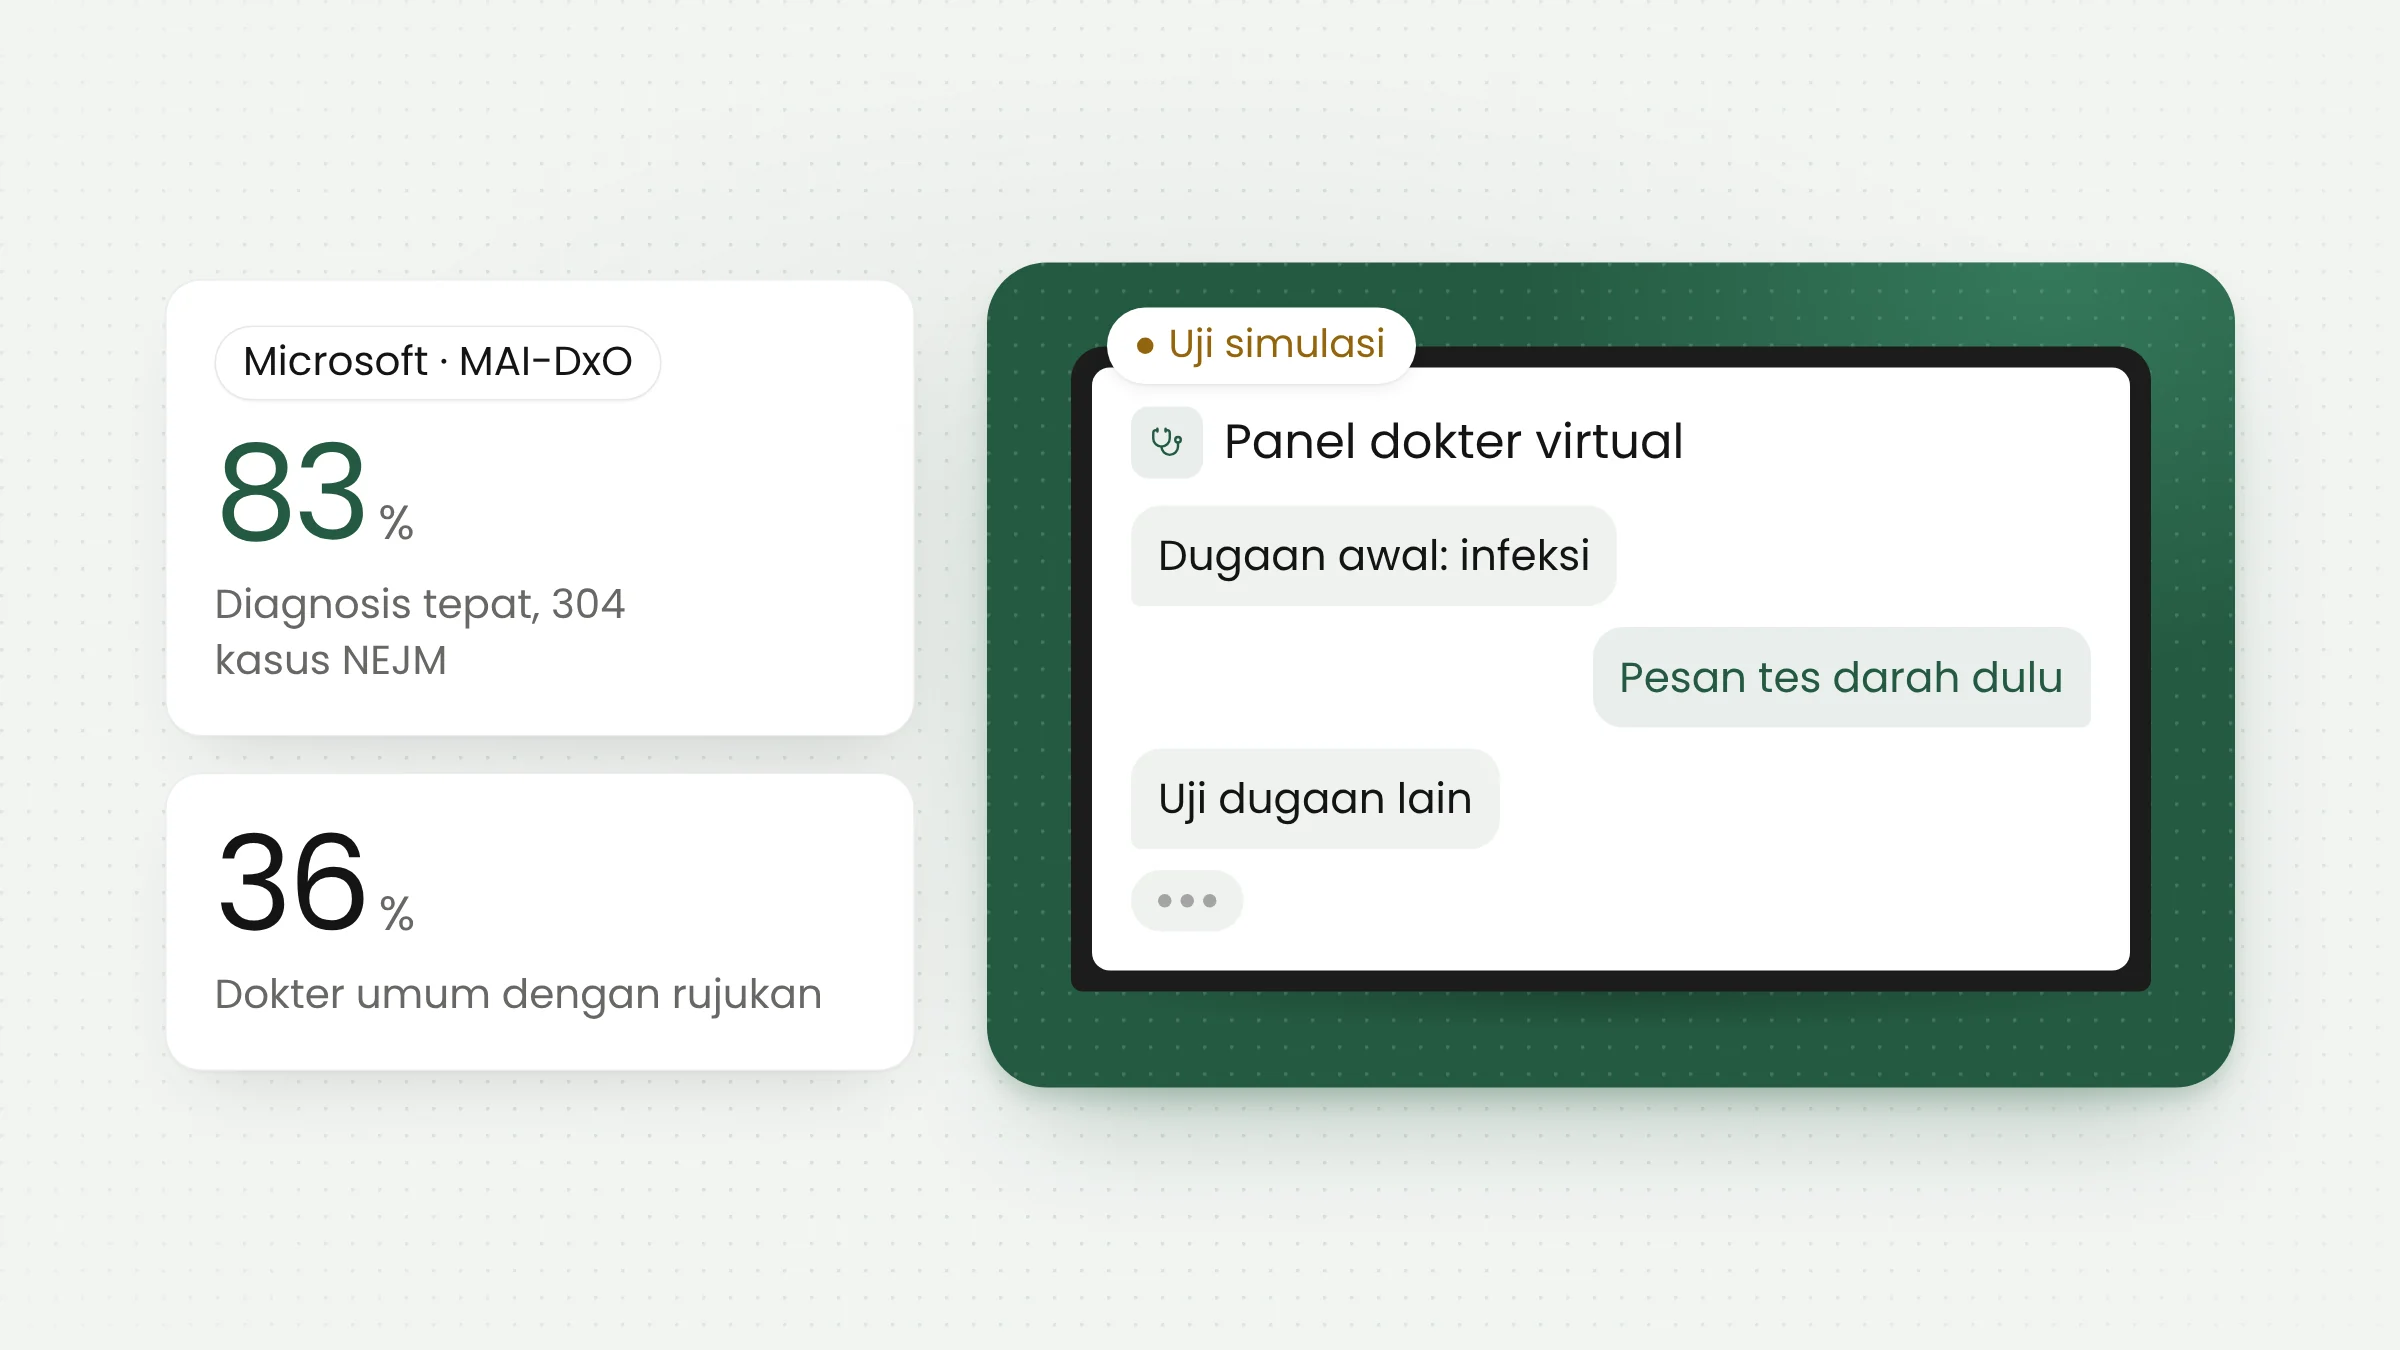
Microsoft menerbitkan hasil uji MAI-DxO, sistem AI untuk diagnosis medis, di jurnal Science pada 22 Oktober 2026. Pada 304 kasus sulit dari New England Journal of Medicine (NEJM), MAI-DxO menetapkan diagnosis yang benar pada 83% kasus. Dokter umum yang boleh membuka buku dan internet mencapai 36%. Uji ini masih berupa simulasi dengan kasus arsip.
Apa yang diumumkan Microsoft
Makalah berjudul “Sequential diagnosis with language models” itu terbit di Science volume 394. Kelima belas penulisnya bekerja di Microsoft, termasuk CEO Microsoft AI Mustafa Suleyman dan Wakil Presiden Bidang Kesehatan Dominic King. Versi awalnya sudah beredar sebagai pracetak di arXiv pada Juni 2025 dan belum melewati telaah sejawat saat itu.
Pada versi pracetak, MAI-DxO yang memakai model o3 dari OpenAI tercatat akurat 80%, sedangkan rata-rata dokter 20%. Versi yang terbit di Science memakai metode yang diperbarui dan model yang lebih baru, sehingga angkanya berbeda. Menurut pengumuman Microsoft AI, hasilnya bertahan dan bahkan membaik saat pengujian diulang dengan model generasi berikutnya, termasuk GPT-5.5.
Microsoft menempatkan studi ini sebagai bagian dari ambisi yang mereka sebut “medical superintelligence”. Dalam wawancara dengan TechCrunch, Dominic King menyatakan, “This technology is ready for real-world evaluations.” Pernyataan itu perlu dibaca bersama batas studi yang diakui para penulisnya sendiri.
Cara MAI-DxO menetapkan diagnosis
Sebagian besar uji AI medis sebelumnya memakai soal pilihan ganda: semua informasi pasien diberikan sekaligus, lalu model memilih jawaban. Studi ini memakai cara yang lebih dekat dengan kerja dokter. Microsoft menyusun tolok ukur bernama Sequential Diagnosis Benchmark (SDBench) dari 304 laporan kasus klinikopatologis NEJM, yaitu kasus yang memang dipilih karena sulit didiagnosis.
Setiap kasus dimulai dari ringkasan singkat. Sistem yang diuji harus bertanya tentang riwayat pasien, meminta hasil pemeriksaan fisik, atau memesan tes laboratorium dan pencitraan satu per satu. Sebuah agen “penjaga” memberikan informasi sesuai permintaan, lalu agen “juri” menilai diagnosis akhir dengan skala satu sampai lima. Skor empat atau lima dihitung benar. Setiap tes yang dipesan juga diberi harga berdasarkan daftar tarif sebuah rumah sakit di Amerika Serikat, sehingga akurasi dan biaya dinilai bersamaan.
MAI-DxO bekerja sebagai orkestrator. Menurut Microsoft, sistem ini meniru panel dokter virtual yang berdebat beberapa putaran: ada yang mengusulkan dugaan penyakit, ada yang memilih pertanyaan atau tes berikutnya, dan ada yang menggugat dugaan yang sedang dipegang. Panel itu juga menimbang apakah sebuah tes cukup bernilai dibandingkan biayanya.
Orkestrator ini tidak terikat pada satu model. Microsoft mengujinya dengan model dari OpenAI, Google, Anthropic, Meta, dan DeepSeek. Hasil terbaik datang dari GPT-5 dan GPT-5.5.
Hasil uji pada kasus sulit dan kasus IGD
Pada 304 kasus NEJM, MAI-DxO dengan GPT-5 mencapai akurasi 83,2%. Dokter umum dan spesialis penyakit dalam yang bekerja sendiri mencapai 36,1% bila boleh memakai bahan rujukan, dan 22,3% tanpa bahan rujukan. Microsoft juga menyebut konfigurasi hemat biaya yang mencapai 81% dengan biaya kurang dari separuh sistem pembanding.
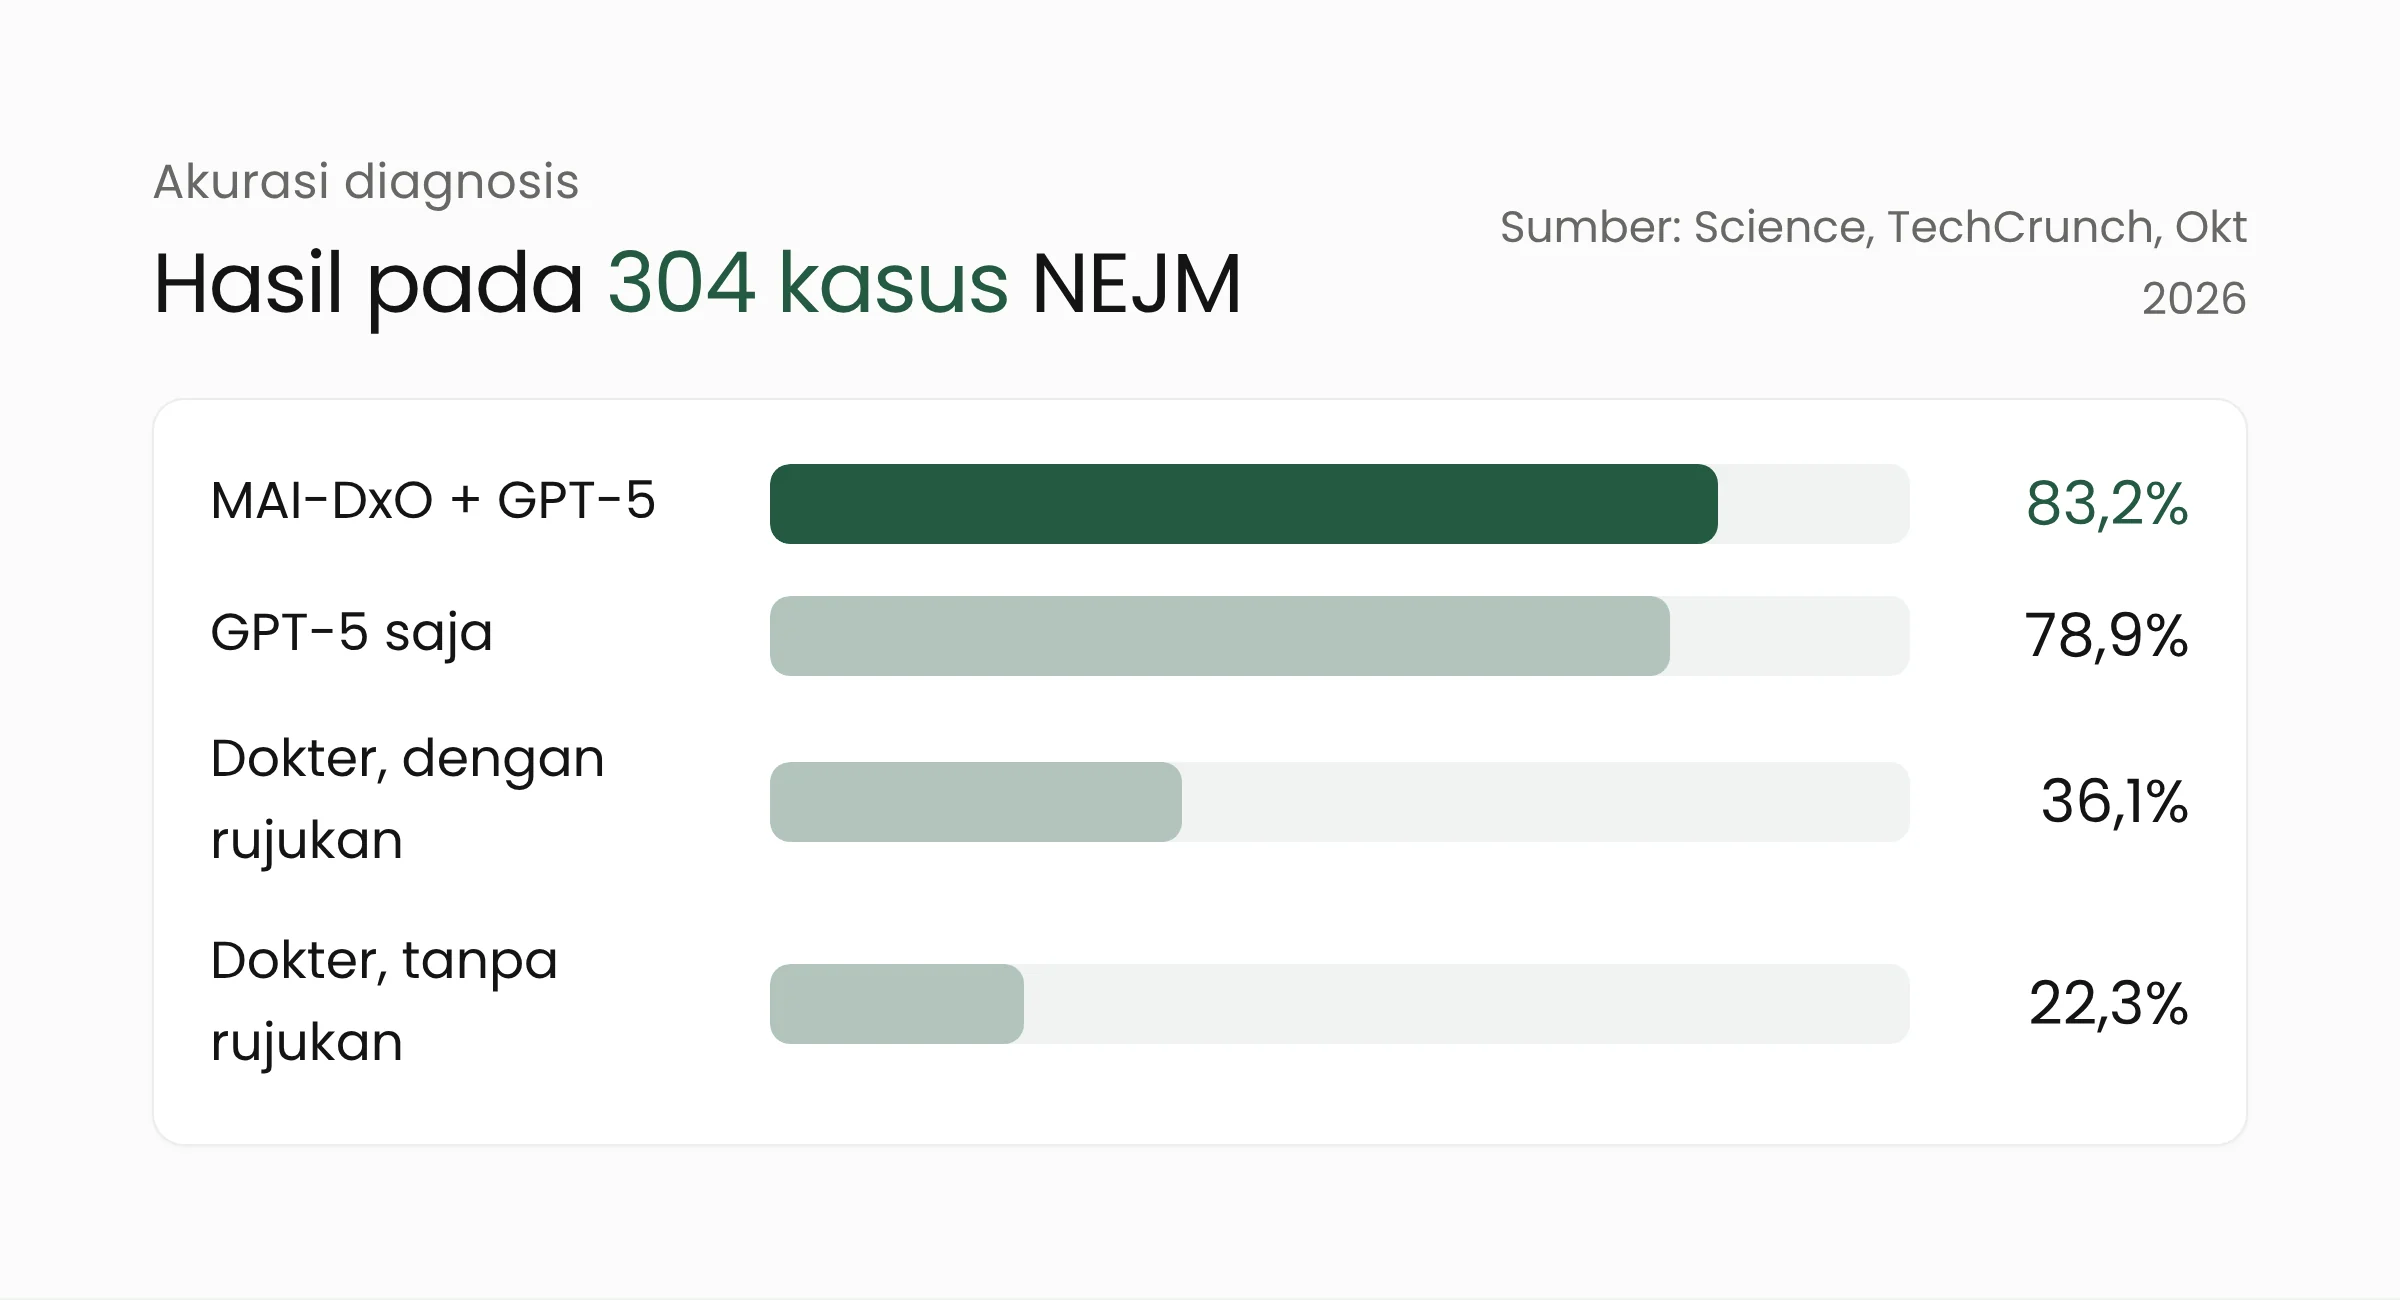
Angka ini perlu dibaca dengan teliti. Menurut TechCrunch, GPT-5 yang dipakai langsung dengan perintah sederhana sudah mencapai 78,9%. Orkestrasi MAI-DxO menambah akurasi sekitar empat poin dan memangkas biaya tes sekitar US$3.000 per kasus. Lonjakan terbesar terlihat pada model yang lebih lemah: Gemini 2.5 Flash naik dari 46,4% menjadi hampir 69%. Jadi, sebagian besar keunggulan atas dokter berasal dari kemampuan model dasarnya, sedangkan orkestrator menambah akurasi dan efisiensi di atasnya.
Microsoft juga menguji kasus instalasi gawat darurat (IGD) yang lebih umum dari basis data MIMIC-IV-ED. Di sini MAI-DxO mencapai 80%, sedangkan dokter 47%. TechCrunch mencatat bahwa pada kasus IGD, orkestrasi hampir tidak menambah akurasi GPT-5 maupun GPT-5.5, karena model dasarnya sudah tinggi.
Batas studi dan langkah berikutnya
Batas yang diakui penulis
Para penulis menyebut beberapa batas yang penting bagi siapa pun yang membaca angka 83%.
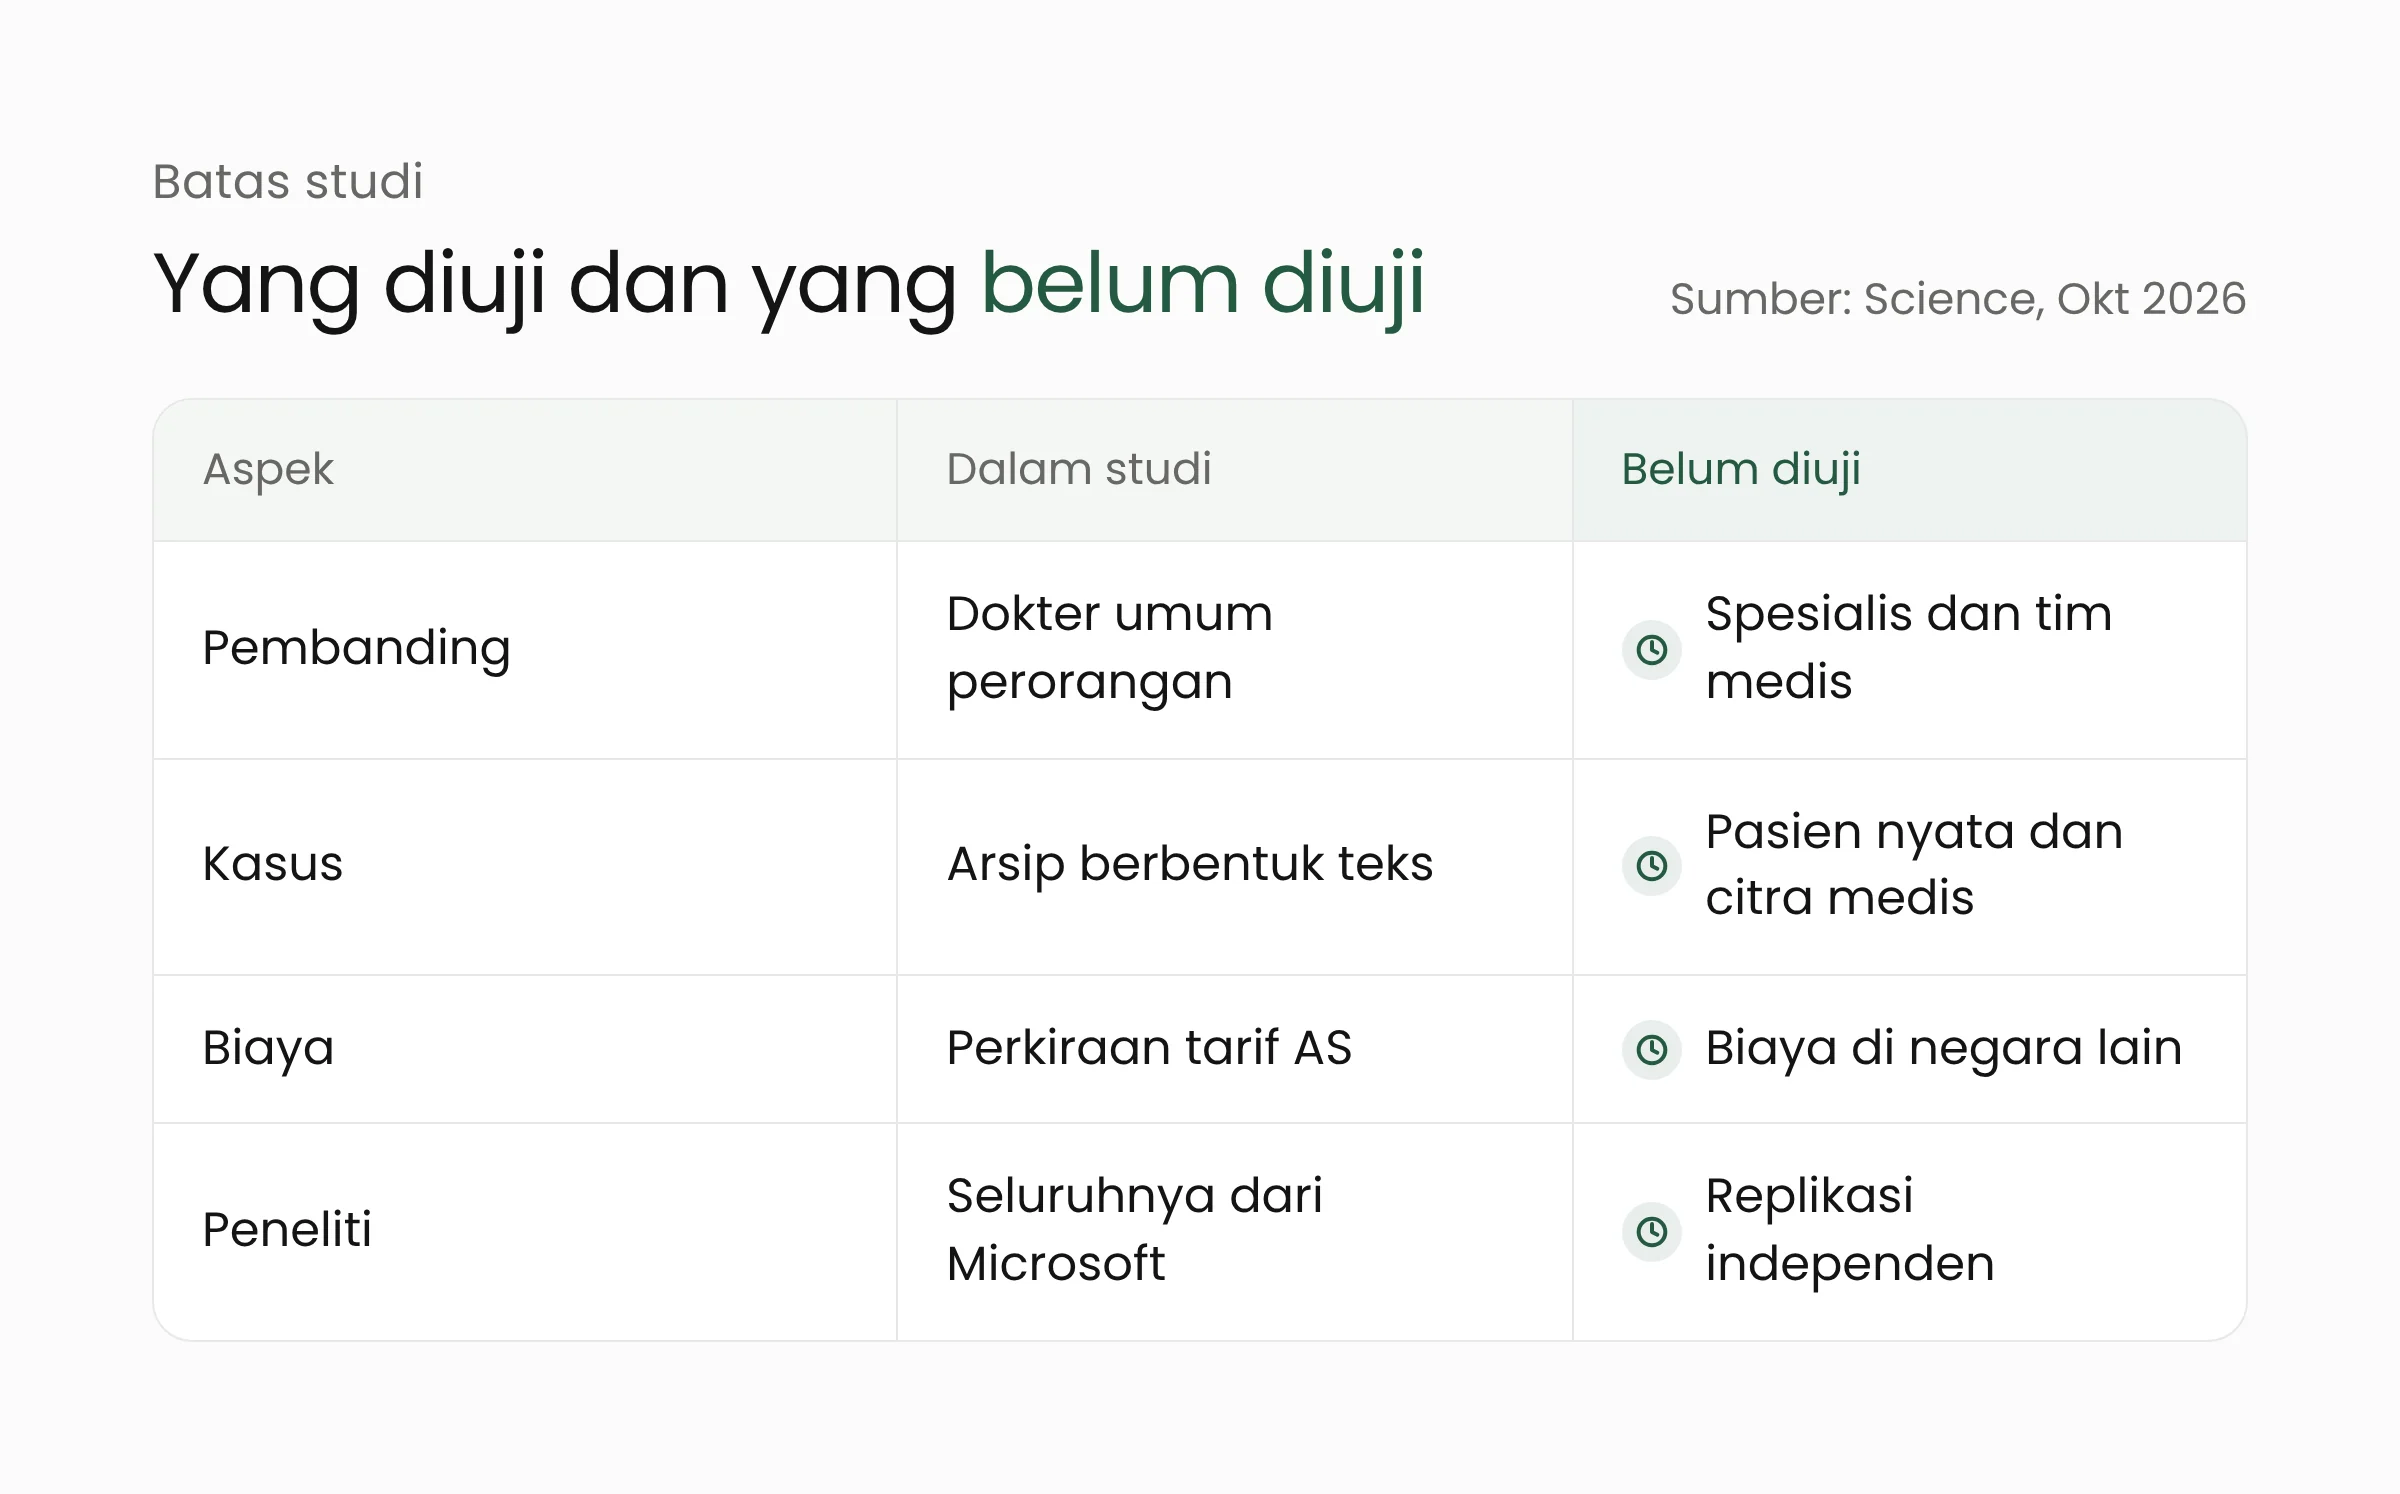
Pertama, pembandingnya dokter umum yang bekerja sendiri. Kasus NEJM biasanya ditangani spesialis atau tim lintas keahlian, dan penulis memperkirakan selisihnya akan menyempit bila MAI-DxO diadu dengan tim seperti itu. Kedua, seluruh kasus adalah arsip berbentuk teks. Simulasi ini tidak memuat riwayat yang samar, rekam medis yang tidak lengkap, hubungan dengan pasien, tindak lanjut jangka panjang, atau data gambar seperti hasil rontgen dan patologi.
Ketiga, kasus NEJM cenderung mewakili penyakit yang sulit dan jarang. Studi ini tidak mengukur alarm palsu pada pasien yang ternyata sehat. Keempat, biaya dihitung dari perkiraan tarif Amerika Serikat, sehingga tidak menggambarkan biaya nyata di negara lain. Terakhir, semua penulis adalah karyawan Microsoft yang memegang saham perusahaan, dan hasilnya belum direplikasi pihak independen.
Sebagian kode SDBench dirilis terbuka di GitHub, termasuk agen penjaga, juri, dan penghitung biaya. Data kasus NEJM tetap memerlukan lisensi dari NEJM Group, sedangkan data MIMIC memerlukan akreditasi lewat PhysioNet. Peneliti lain dapat memakai perangkat ini untuk menguji ulang klaimnya.
Uji pada pasien nyata
Microsoft akan menjalankan studi prospektif bersama Beth Israel Deaconess Medical Center di Boston. Pasien tetap menerima perawatan standar, sementara pasien yang setuju juga berinteraksi langsung dengan MAI-DxO. Rekomendasi sistem kemudian dibandingkan dengan penilaian dokter yang dibuat secara terpisah. Tanggal mulai dan jumlah pesertanya belum diumumkan, dan MAI-DxO belum dijual sebagai produk.
Persaingan di bidang ini juga ketat. TechCrunch mencatat bahwa Google menerbitkan studi sistem AMIE bersama Beth Israel di jurnal The Lancet bulan ini, dan OpenAI pernah membuat klaim serupa. Microsoft juga bekerja sama dengan Mayo Clinic untuk membangun model AI kesehatan yang direncanakan rilis pada 2027.
Apa artinya bagi rumah sakit?
Di Indonesia, dokter umum di puskesmas, klinik, dan IGD rumah sakit daerah sering menjadi pihak pertama yang menghadapi gejala yang tidak biasa. Alat bantu keputusan klinis yang andal dapat membantu mereka memutuskan kapan perlu tes tambahan dan kapan pasien perlu dirujuk. Namun, hasil studi ini belum cukup untuk dijadikan dasar pembelian atau penerapan langsung.
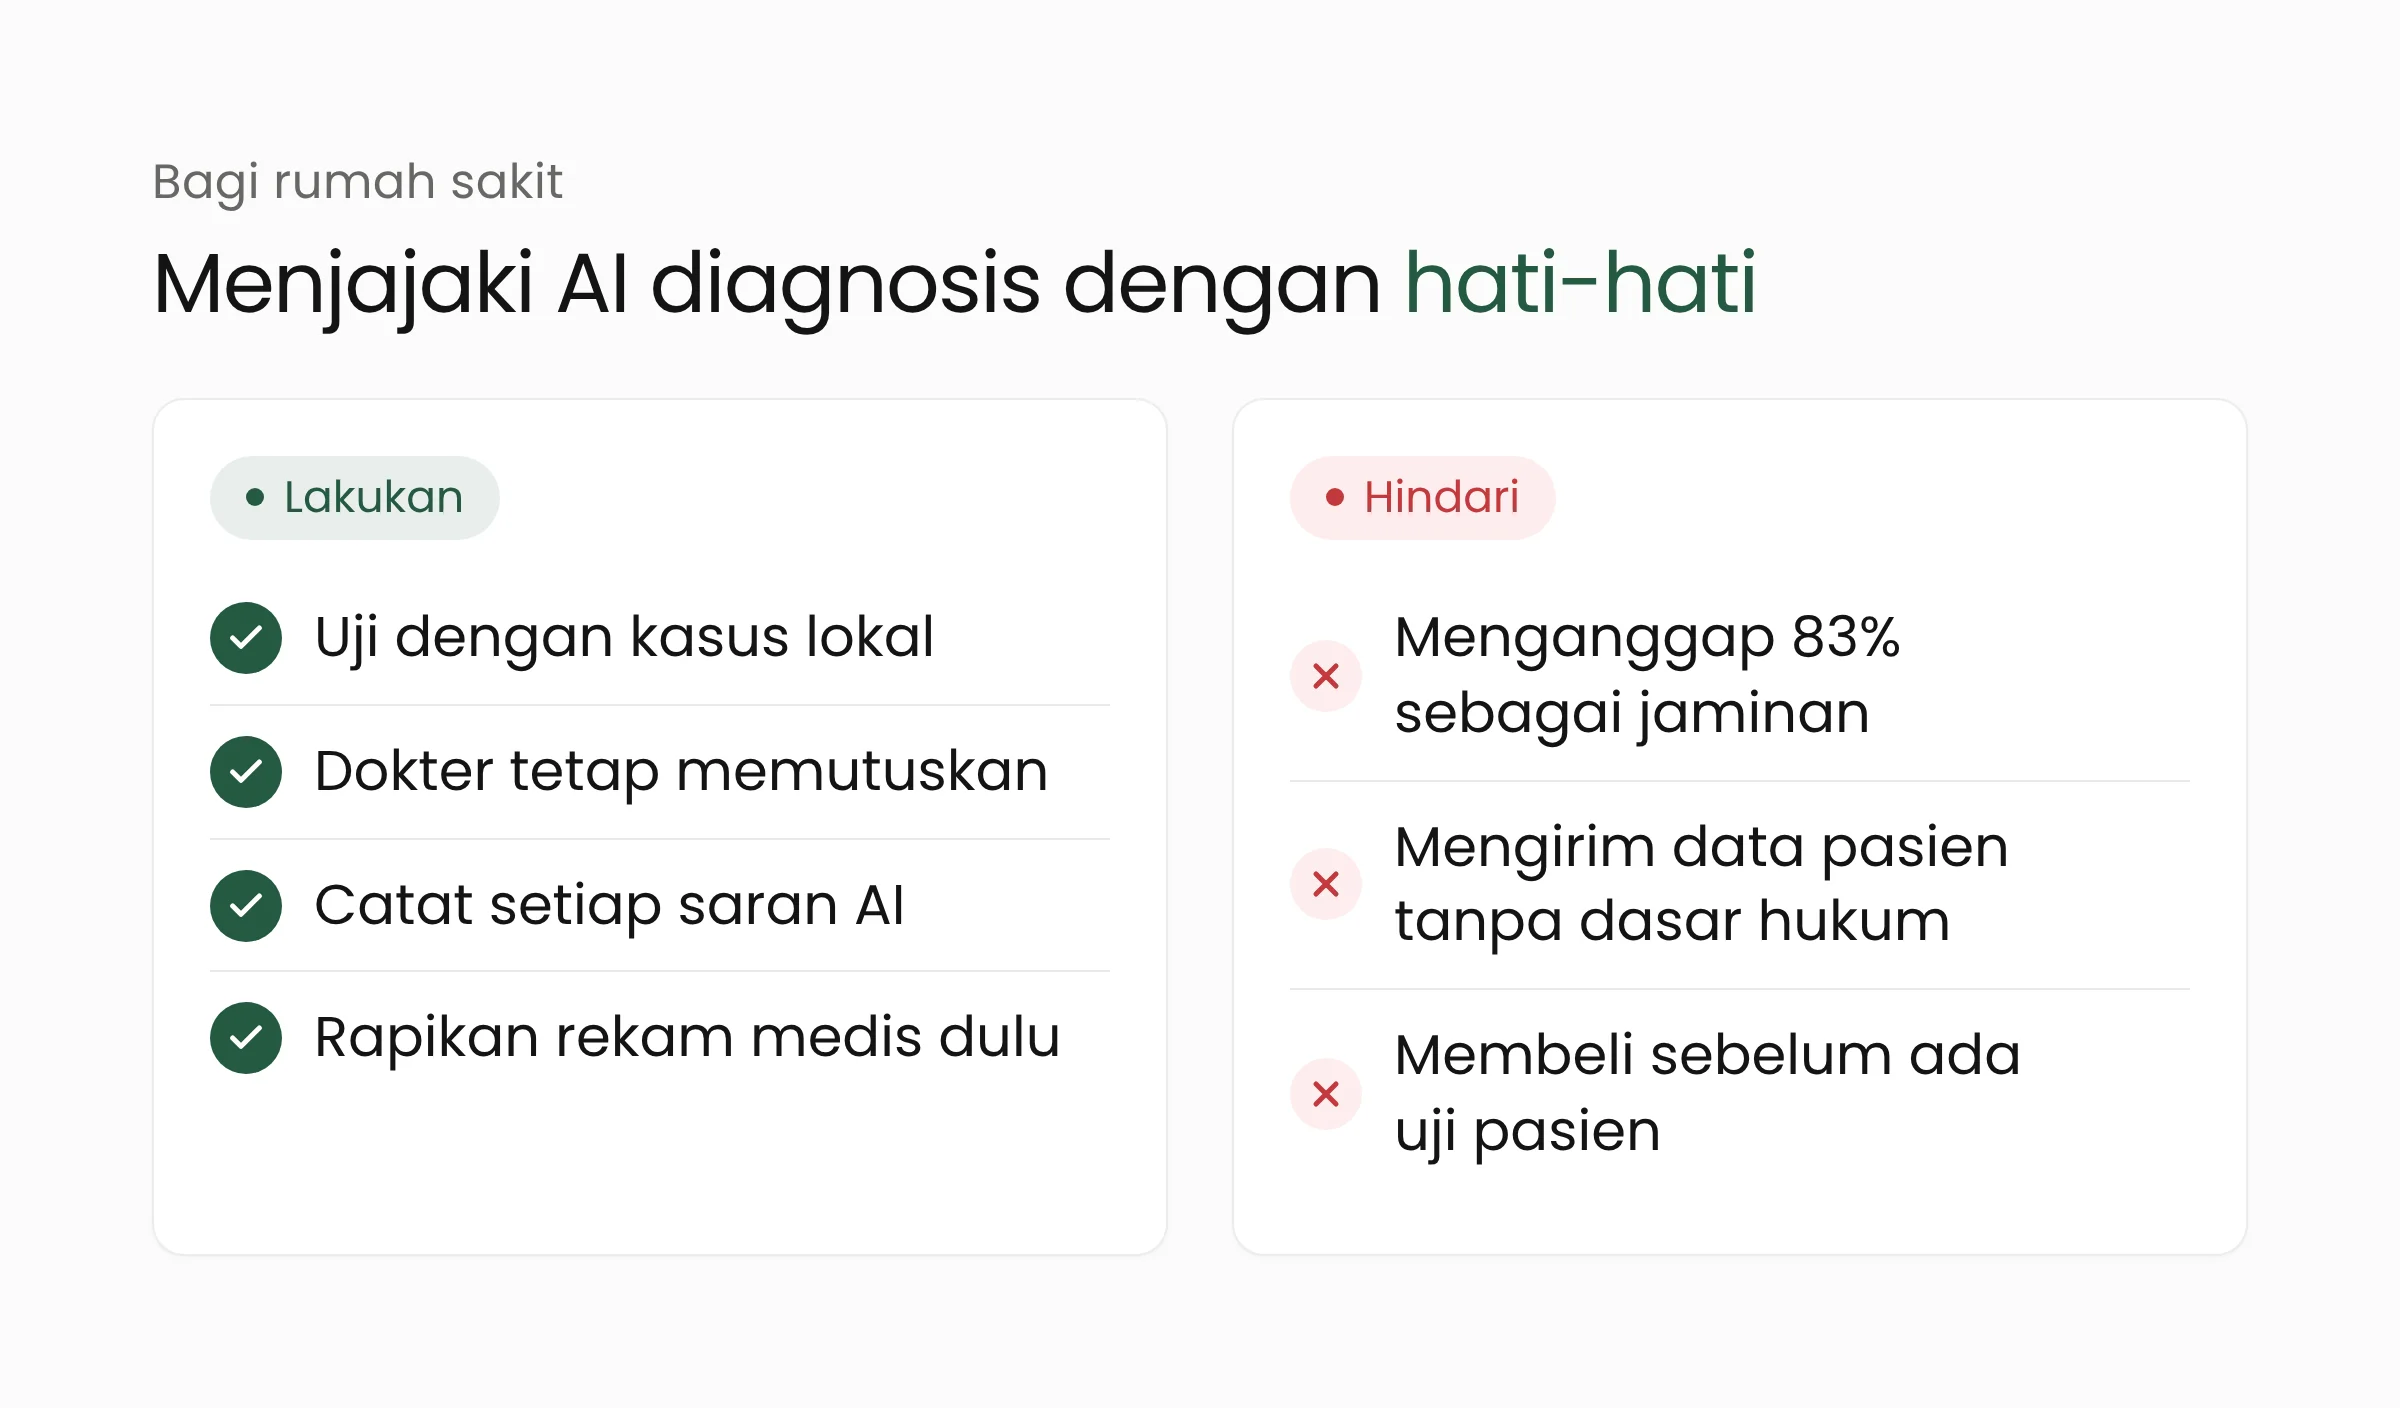
Beberapa pertimbangan bagi manajemen rumah sakit dan tim informatika medis:
- Uji dengan kasus lokal. Penyakit tropis, pola rujukan, dan ketersediaan tes di Indonesia berbeda dari kasus NEJM. Kumpulkan kasus anonim dari rumah sakit sendiri sebelum menilai alat apa pun.
- Dokter tetap pengambil keputusan. Posisikan AI sebagai pemberi pendapat kedua yang jawabannya dicatat, diperiksa, dan dapat ditolak dokter.
- Rapikan data lebih dulu. Sistem seperti ini bergantung pada riwayat, hasil laboratorium, dan catatan klinis yang lengkap. Rekam medis elektronik yang terhubung ke SATUSEHAT menjadi fondasi yang lebih penting daripada pilihan model.
- Periksa dasar hukum pengolahan data. UU Nomor 27 Tahun 2022 tentang Pelindungan Data Pribadi menggolongkan data kesehatan sebagai data pribadi yang bersifat spesifik. Pengiriman data pasien ke layanan AI di luar negeri perlu kajian hukum dan persetujuan yang jelas.
- Ukur biaya dalam konteks sendiri. Penghematan biaya tes dalam studi dihitung dengan tarif Amerika Serikat. Hitung ulang dengan tarif dan pola pembiayaan di rumah sakit Anda.
Tim yang ingin memulai dapat memilih satu alur kerja sempit, misalnya ringkasan kasus untuk rapat rujukan, lalu mengukur hasilnya secara terbuka. Merakit membantu rumah sakit menyiapkan data dan alur kerja seperti ini lewat solusi kesehatan digital dan layanan kecerdasan buatan.
Pertanyaan yang sering muncul
Apakah MAI-DxO sudah dapat dipakai rumah sakit?
Belum. Microsoft belum mengumumkan tanggal rilis komersial. Langkah berikutnya adalah studi prospektif dengan pasien di Beth Israel Deaconess Medical Center, yang tanggal mulainya juga belum diumumkan.
Apakah AI ini lebih baik daripada dokter?
Pada uji simulasi dengan kasus sulit, MAI-DxO lebih akurat daripada dokter umum yang bekerja sendiri. Studi ini tidak membandingkannya dengan dokter spesialis atau tim medis, dan belum menguji dampaknya pada keselamatan pasien.
Mengapa angkanya berbeda dari berita tahun lalu?
Pracetak Juni 2025 memakai model o3 dan melaporkan 80% berbanding 20%. Versi Science memakai metode yang diperbarui dan model GPT-5, sehingga angkanya menjadi 83,2% berbanding 36,1% untuk dokter dengan bahan rujukan.
Penutup
MAI-DxO menunjukkan bahwa AI dapat menelusuri kasus sulit langkah demi langkah sambil memperhitungkan biaya tes. Bukti dari pasien nyata baru akan datang lewat studi lanjutan. Sambil menunggu, rumah sakit dapat menyiapkan data klinis yang rapi dan aturan pemakaian AI yang jelas. Bila tim Anda ingin mendiskusikan langkah awalnya, Merakit siap membantu.
Sumber
- Science, Sequential diagnosis with language models, 22 Oktober 2026
- Microsoft AI, Building Medical Superintelligence, 22 Oktober 2026
- TechCrunch, Microsoft’s Mustafa Suleyman says its AI outperforms doctors on hard cases, 22 Oktober 2026
- Unite.AI, Microsoft Diagnostic AI Outperforms Generalist Physicians in Science Study, Oktober 2026
- Microsoft, SDBench (kode dan data tolok ukur)
- arXiv, Sequential Diagnosis with Language Models (pracetak), Juni 2025