Blog TorchNeuron
TorchNeuron: Kode PyTorch Kini Jalan di Chip Trainium
Daftar isi· 7 bagian
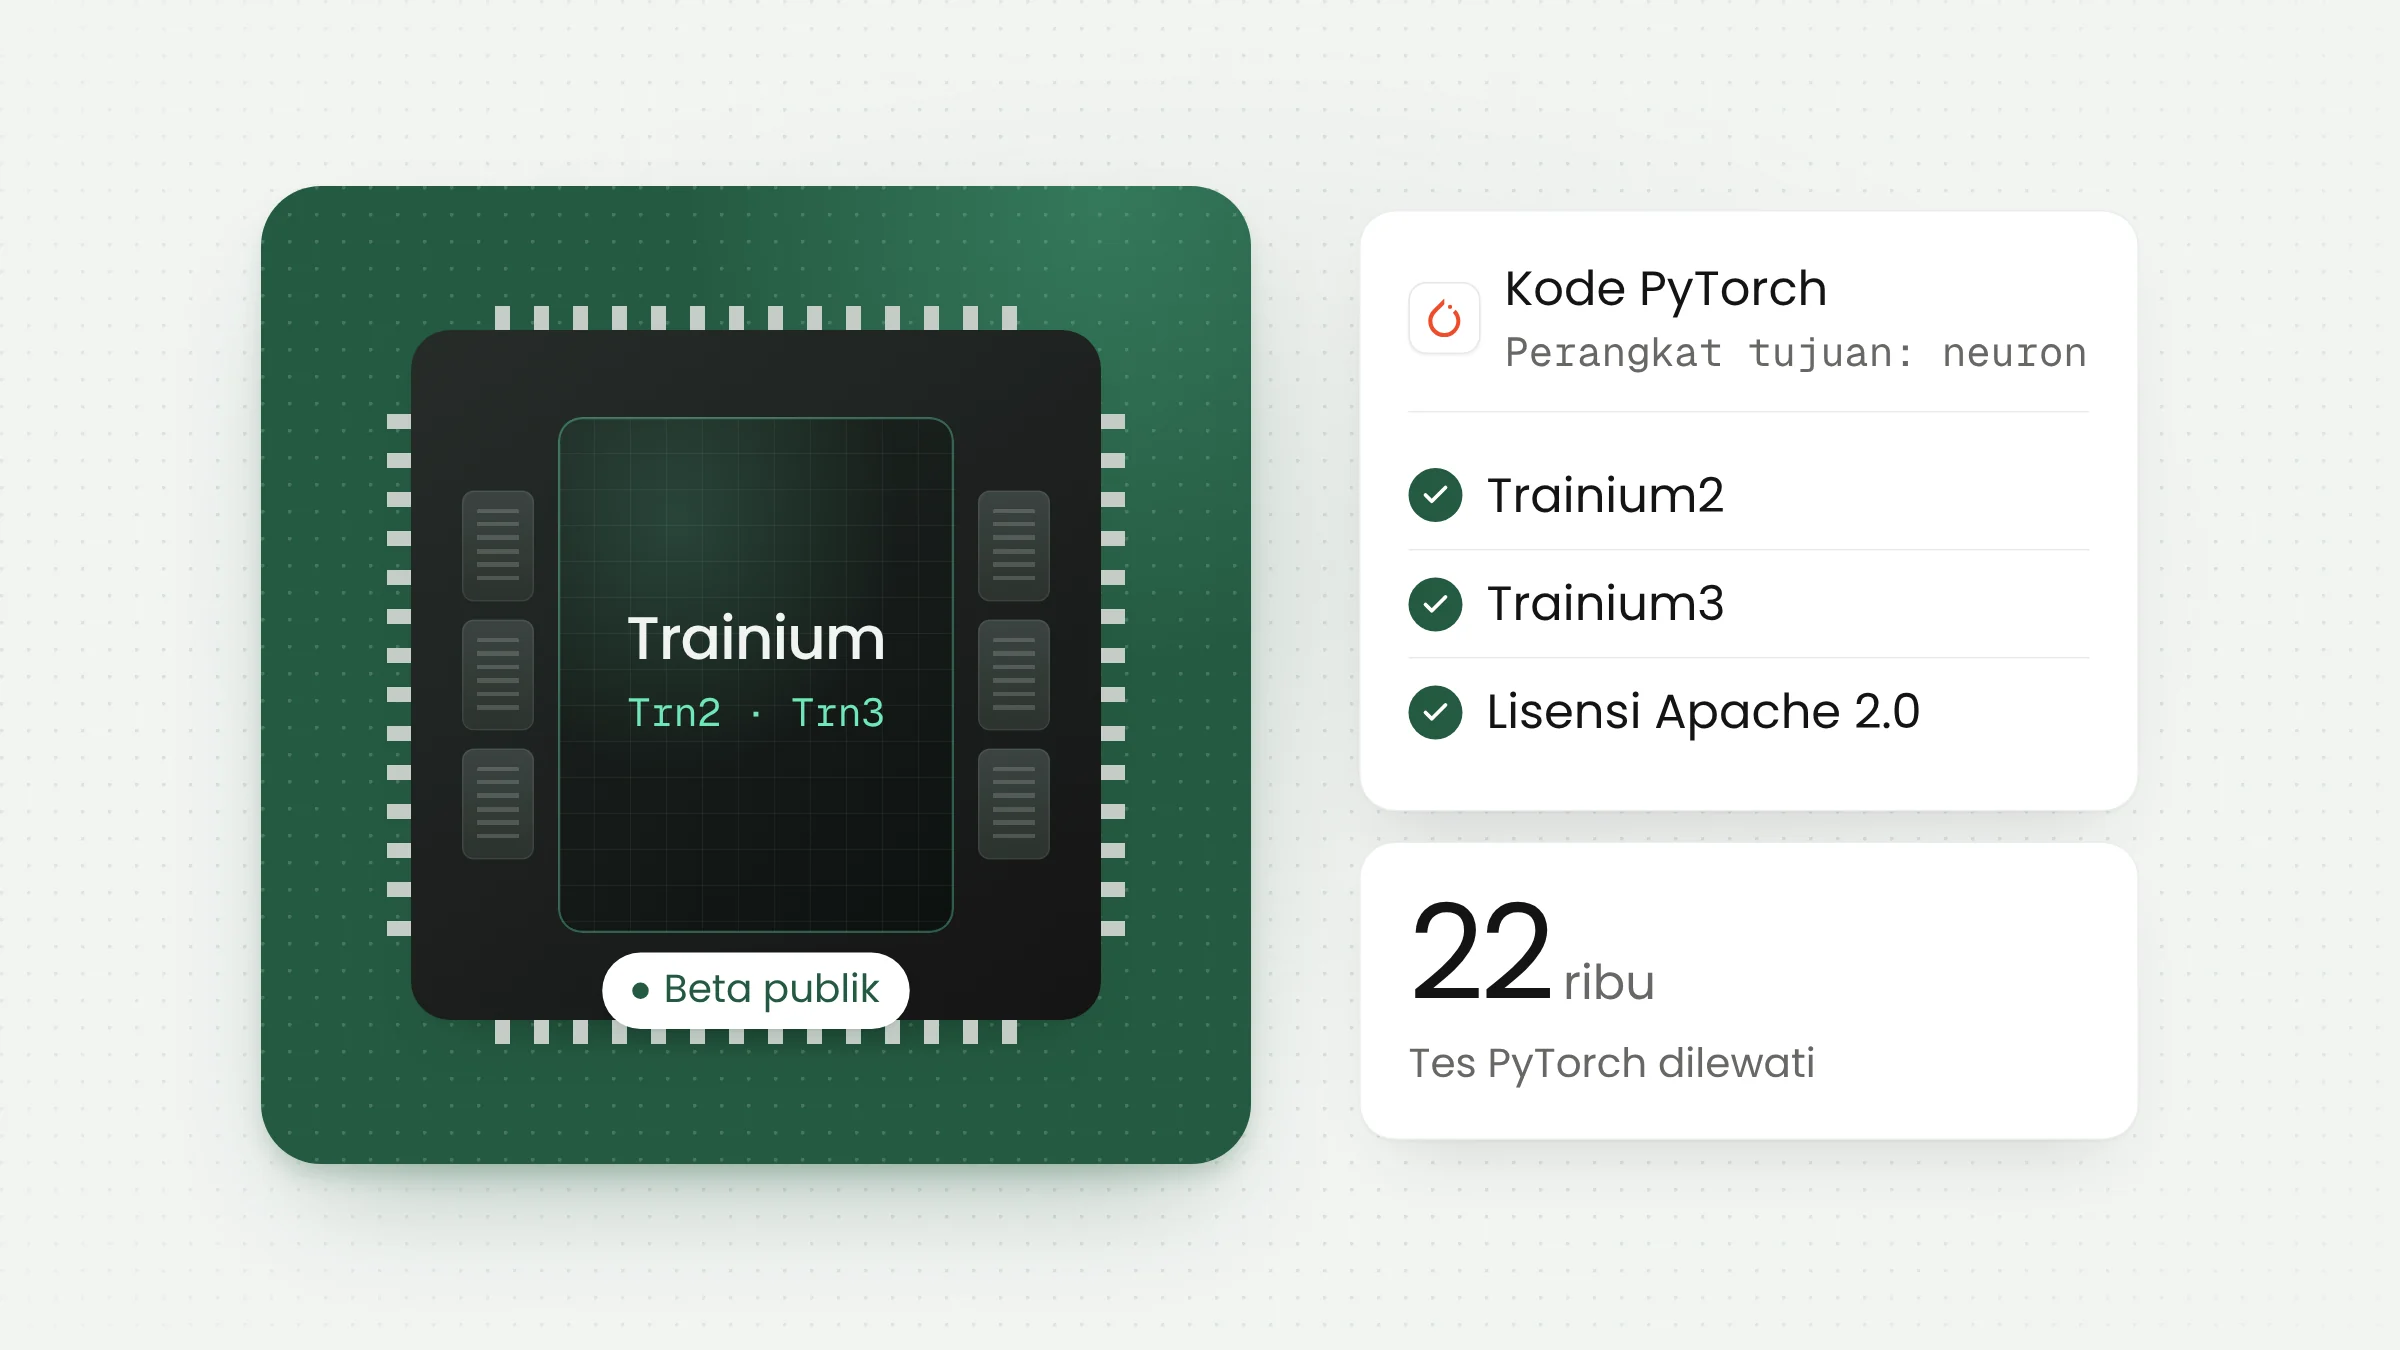
Amazon merilis TorchNeuron, perangkat lunak sumber terbuka yang membuat kode PyTorch dapat berjalan langsung di chip AI Trainium2 dan Trainium3 buatan AWS. Beta publiknya dibuka pada 20 Oktober 2026 dalam konferensi PyTorch Conference North America. Amazon menyatakan perpindahan dari chip lain cukup lewat satu pengaturan perangkat.
Yang diumumkan Amazon dan PyTorch
PyTorch adalah kerangka kerja yang dipakai untuk menyusun dan melatih model AI. Trainium adalah chip AI rancangan AWS yang disewakan lewat layanan cloud Amazon. Selama ini, kedua hal itu tidak otomatis cocok: menurut Techzine, Amazon menyebut memindahkan kode PyTorch ke chip lain sebelumnya memerlukan penulisan ulang dan pengujian ulang selama berbulan-bulan.
TorchNeuron dirancang untuk menghilangkan pekerjaan itu. Amazon mengumumkannya pada 19 Oktober 2026 dan membuka beta publiknya sehari kemudian. Kodenya berlisensi Apache 2.0 dan tersedia di GitHub dengan nama aws-neuron/torch-neuronx. Pengembang dapat memasangnya dengan perintah pip install torch-neuronx. Chip yang didukung adalah Trainium2 dan Trainium3.
Amazon menyatakan sekitar 85 persen peneliti dan pengembang AI menulis kode dengan PyTorch, sehingga dukungan asli di Trainium menjadi syarat agar chip itu dilirik. The Next Web menempatkan peluncuran ini dalam upaya Amazon menyaingi Nvidia, yang chip dan perangkat lunak CUDA-nya mendominasi komputasi AI. Persaingan di lapisan chip juga terlihat pada pendanaan Tenstorrent untuk chip AI terbuka.
Tim PyTorch di Meta mengembangkan mekanisme ekstensi yang menjadi dasar TorchNeuron, dan Meta ikut memberi pernyataan di blog PyTorch. Jana van Greunen, Director of PyTorch Engineering di Meta, menyatakan pengembang seharusnya mendapat pengalaman yang konsisten di berbagai platform perangkat keras.
Cara kerja dan batasan rilis awal
TorchNeuron mendaftarkan Trainium sebagai perangkat standar PyTorch lewat mekanisme ekstensi resmi bernama PrivateUse1. Karena itu, pengembang cukup menandai model atau data dengan perangkat neuron, misalnya .to('neuron'), dan fungsi PyTorch seperti pelatihan terdistribusi serta profiler tetap berjalan seperti biasa.
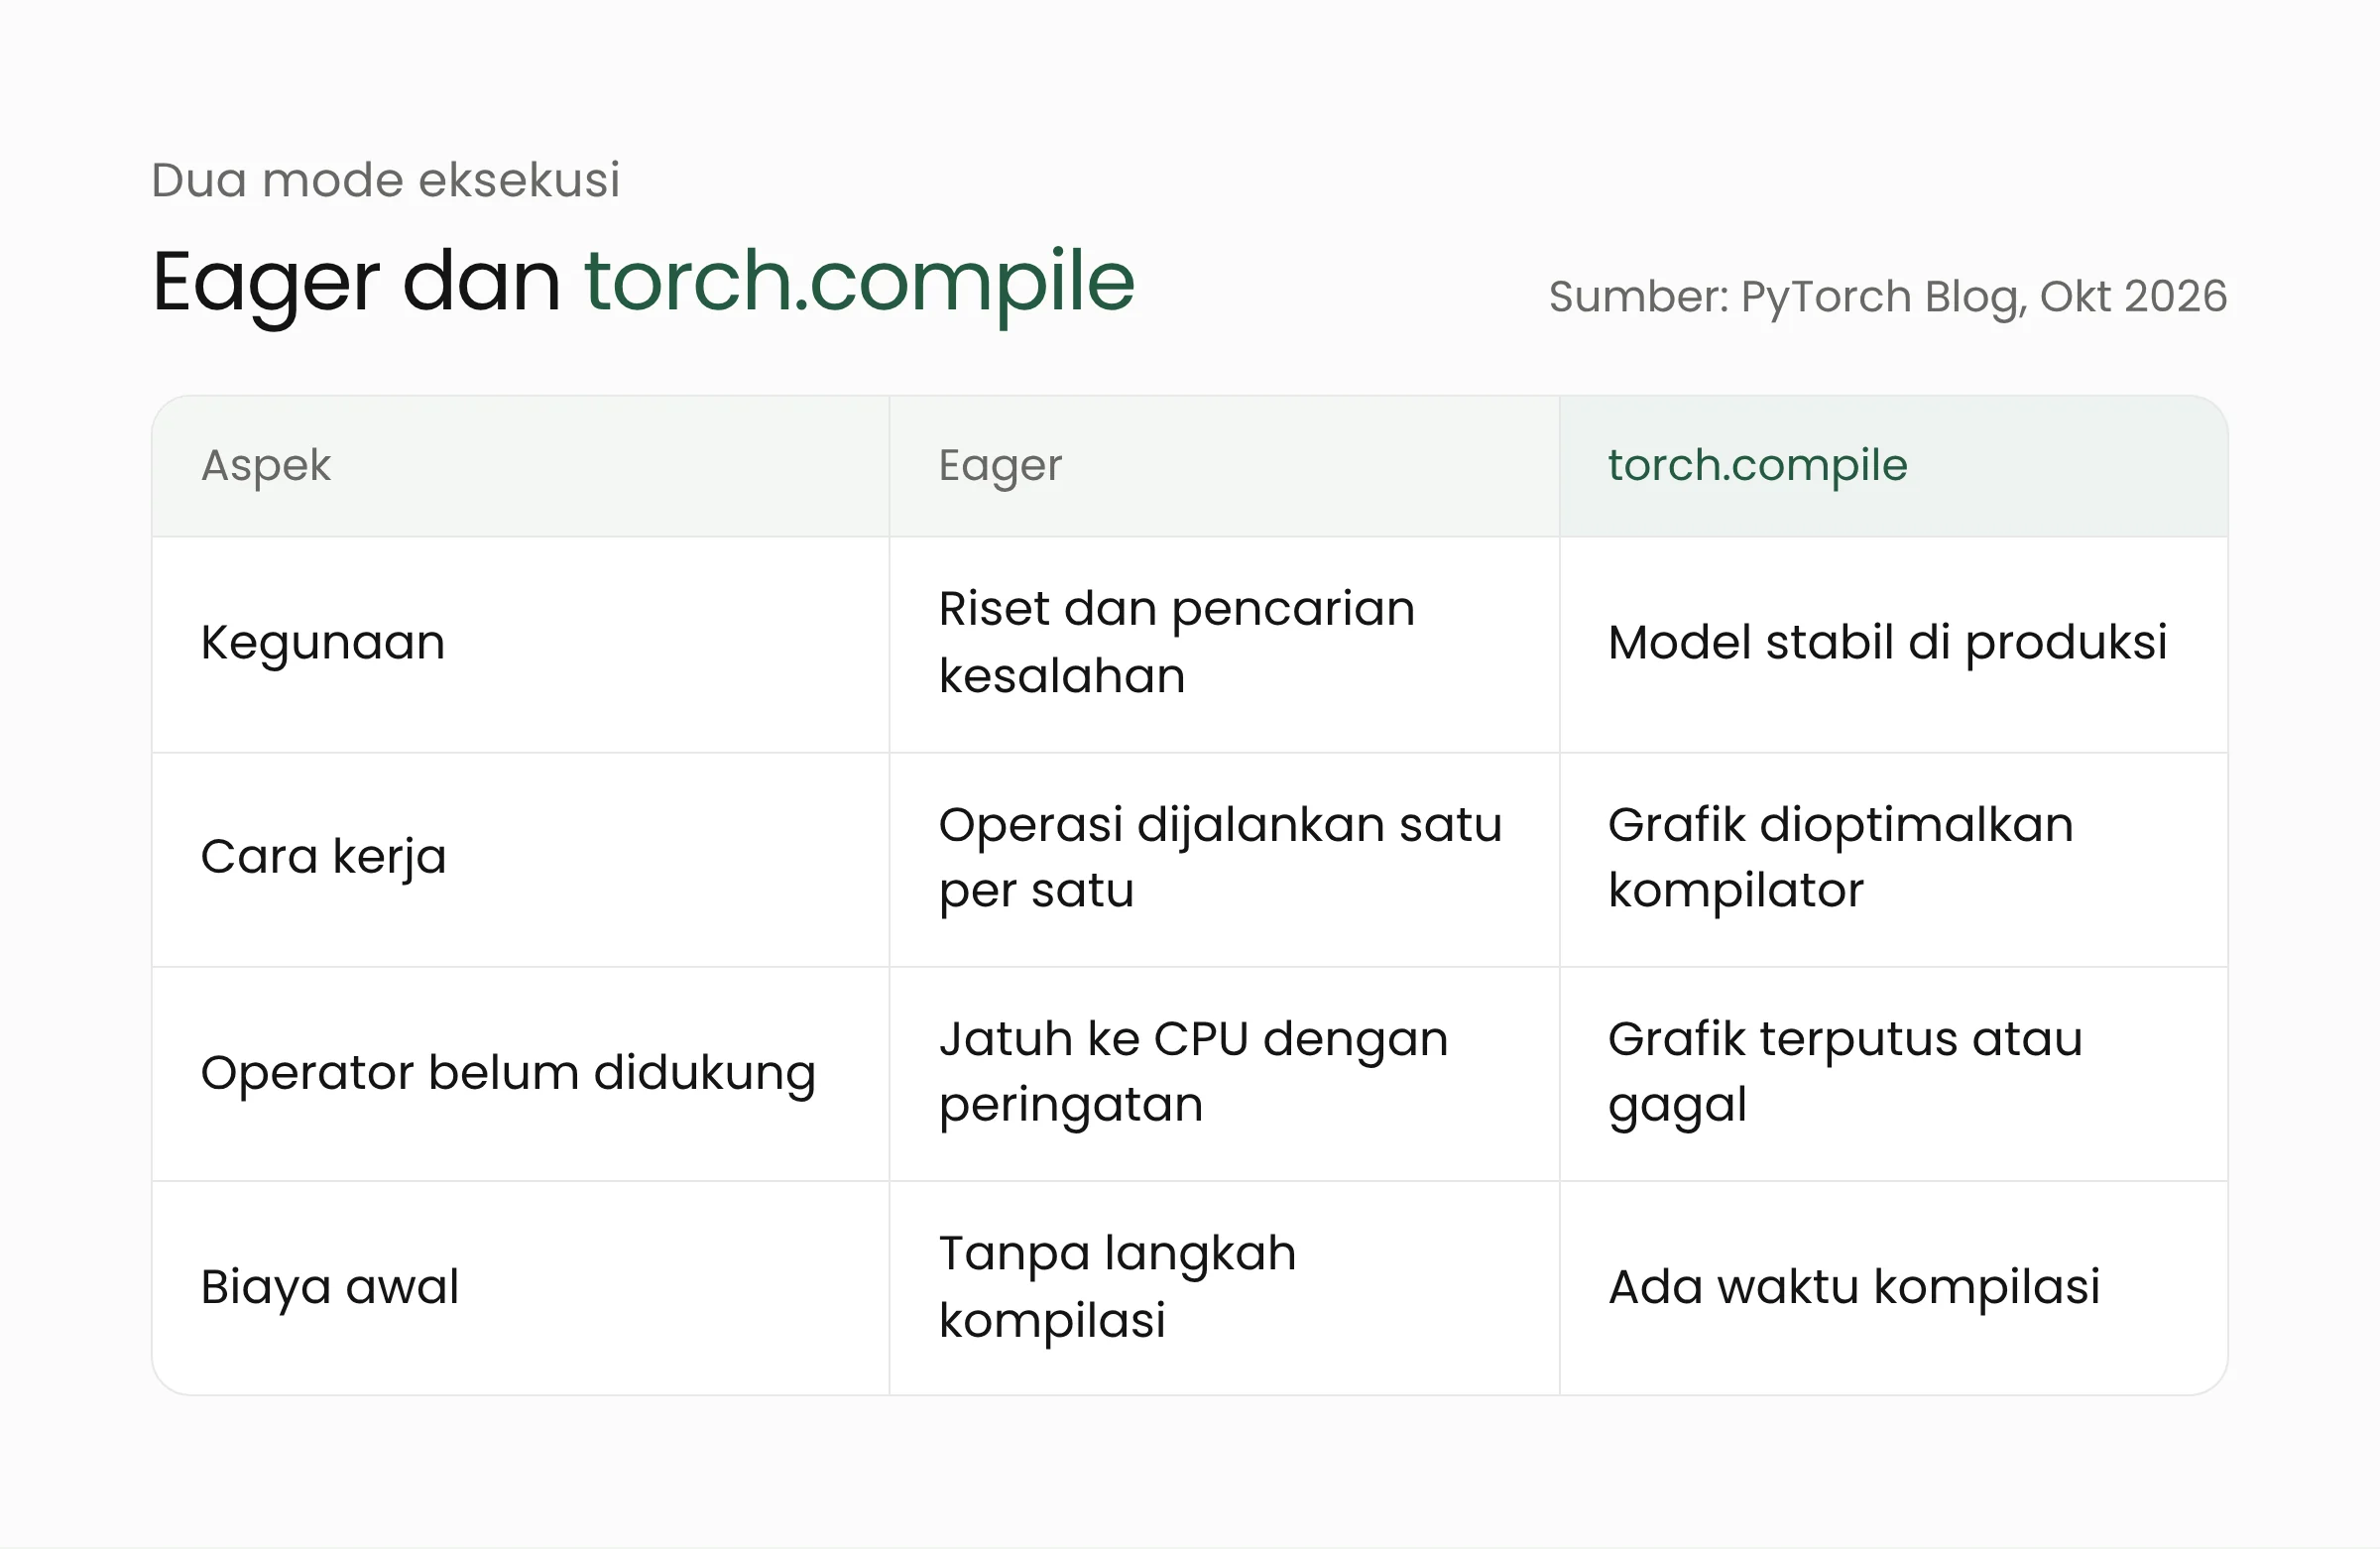
Ada dua mode eksekusi. Mode eager menjalankan operasi satu per satu dan cocok untuk riset serta pencarian kesalahan. Mode torch.compile dengan backend neuron menyusun model menjadi grafik yang dioptimalkan kompilator Neuron, dan dimaksudkan untuk model yang sudah stabil di produksi. Untuk bagian yang butuh kendali lebih, pengembang dapat menulis kernel khusus dengan Neuron Kernel Interface (NKI). AWS juga merilis pustaka kernel NKI-lib yang mencakup FlashAttention dan kernel mixture-of-experts.
TorchNeuron mendukung API terdistribusi standar PyTorch seperti DDP, FSDP2, paralelisme tensor, dan paralelisme pipeline, serta terintegrasi dengan TorchTitan, pustaka PyTorch untuk pelatihan berskala besar. Profiler bawaan PyTorch dapat dipakai untuk menelusuri hambatan kinerja sampai ke baris kode melalui alat Neuron Explorer. Amazon juga menyatakan ikut menyumbangkan perubahan ke PyTorch dan vLLM agar kode kerangka kerja tidak terikat pada chip tertentu.
Rilis awal ini masih beta dan memiliki celah yang diakui AWS di blog PyTorch. Dalam uji AWS pada Agustus 2026, sekitar 22 ribu tes dari rangkaian uji PyTorch dilewati karena operator terkait belum punya implementasi asli di Neuron. Fitur yang sengaja belum didukung pada rilis pertama mencakup tensor jarang (sparse), NestedTensor, autograd mode maju, serta bentuk input dinamis. FP8 dan TorchAO masih berada di beta privat.
Dokumentasi Neuron menjelaskan dampaknya di lapangan. Pada mode eager, operator yang belum didukung dijalankan di CPU dengan peringatan, sehingga model tetap jalan tetapi dapat melambat. Pada torch.compile, konstruksi yang tidak didukung memutus grafik dan mengurangi peluang optimasi. Tipe float64 juga dijalankan sebagai float32.
AWS menyatakan menguji TorchNeuron secara rutin dengan 100 ribu model Hugging Face yang mencakup 99,9 persen penggunaan nyata berdasarkan jumlah unduhan. Hasilnya sampai September 2026 masih menyisakan celah yang akan ditutup di rilis berikutnya, menurut AWS sendiri.
Pengguna awal dan klaim biayanya
Dalam uji internal, Amazon menjalankan skrip pelatihan yang sama di chip konvensional dan di Trainium dengan perbedaan hanya pada pengaturan perangkat, lalu menyatakan model belajar sama baiknya dengan laju yang sama di keduanya. Hasil itu belum diverifikasi pihak independen. Blog PyTorch menyebut TorchNeuron sudah dipakai di bidang kendaraan otonom, robotika, pembuatan video, suara, telekomunikasi, kesehatan, dan pemodelan geospasial. Tiga contohnya dapat dibandingkan.
Cartesia, pengembang AI suara, menjalankan alur inferensi standarnya di Trainium dengan perubahan minimal pada kode PyTorch. Tim mereka lalu memusatkan tenaga menulis kernel NKI untuk lapisan yang paling sering dipanggil. Deepgram, perusahaan pengenalan suara, menyatakan hasil yang lebih konkret: dalam tolok ukur yang mereka evaluasi, Trainium memproses sekitar 60 persen lebih banyak detik audio per dolar daripada pembanding GPU mereka. Angka itu berasal dari proyek pemindahan model selama beberapa bulan bersama AWS Generative AI Innovation Center, dan tidak berasal dari pergantian cepat.
Lieber Institute for Brain Development, lembaga riset otak yang menangani antara lain skizofrenia, memakai TorchNeuron untuk menjajaki model AI yang dapat mempercepat atau menggantikan simulasi dinamika molekul yang berat secara komputasi, menurut Amazon. Hugging Face juga menambahkan dukungan Trainium ke pustaka Transformers dan Diffusers, sehingga model terbuka dapat dimuat ke chip itu tanpa kode khusus perangkat.
Semua angka kinerja di atas berasal dari AWS atau pelanggannya. Techzine mencatat bahwa peluncuran ini belum disertai tolok ukur kinerja independen maupun rincian harga, jadi perbandingan biaya perlu diuji sendiri.
Apa artinya bagi tim data dan AI di organisasi Anda?
Bagi bank, rumah sakit, atau instansi yang melatih dan menjalankan model sendiri di cloud, TorchNeuron menambah satu pilihan perangkat keras tanpa menuntut perubahan kerangka kerja. Pilihan itu layak ditimbang, tetapi sebaiknya lewat uji coba terukur.
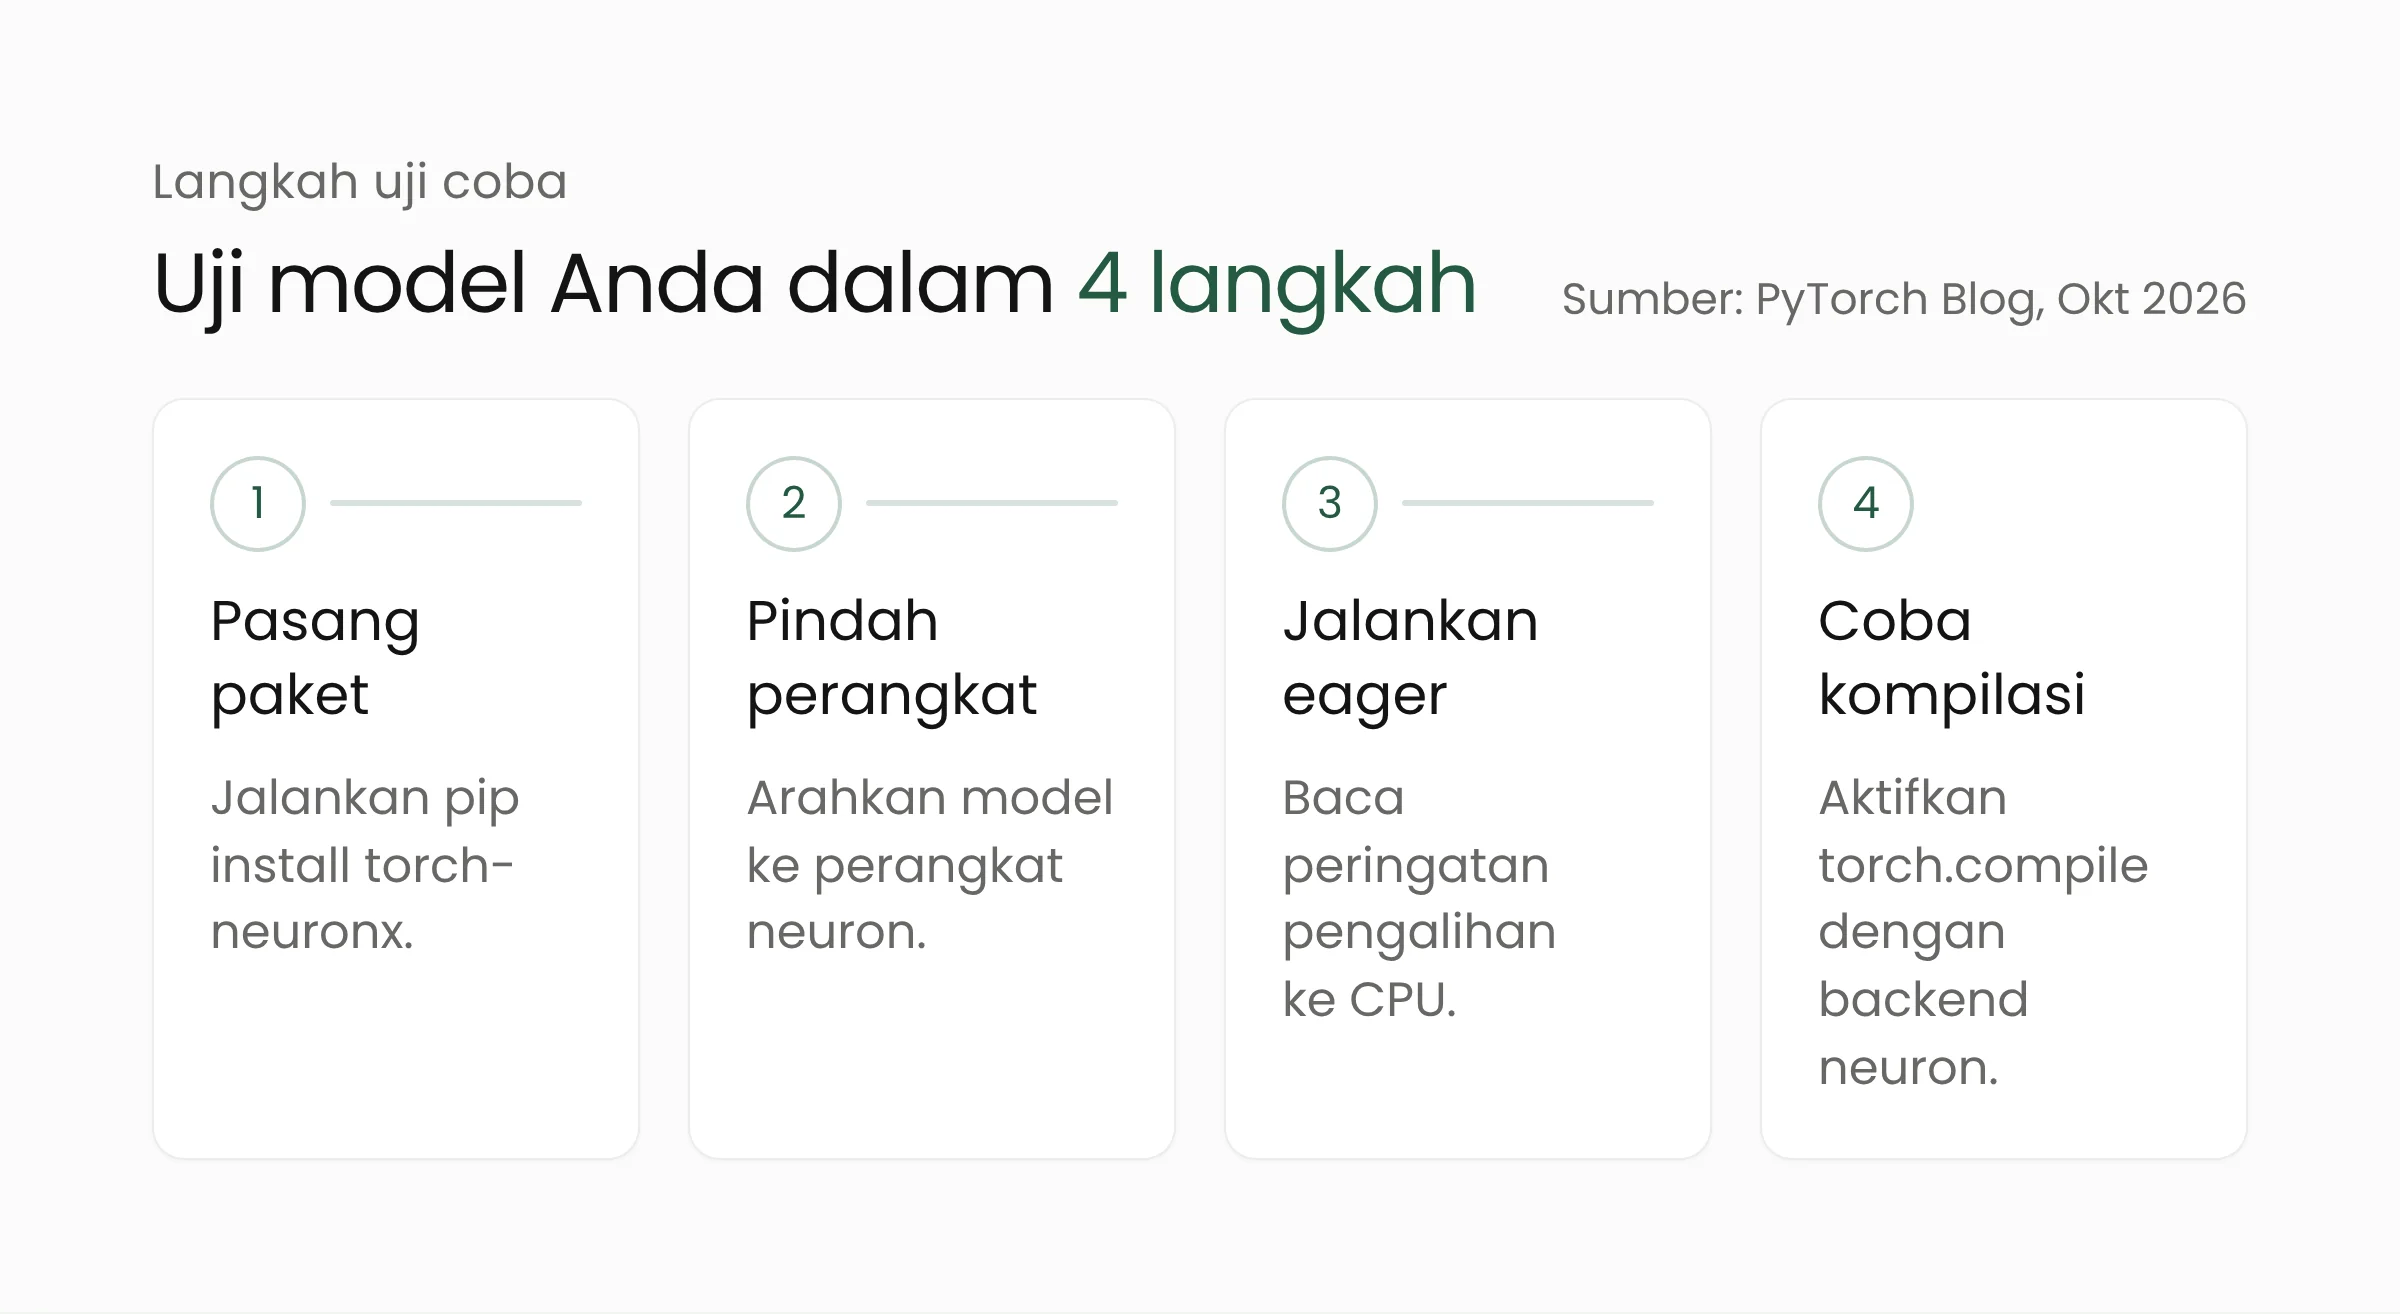
Beberapa pertimbangan konkret untuk uji coba:
- Uji model Anda sendiri. Klaim “satu pengaturan” berlaku untuk titik awal. Model yang memakai bentuk input dinamis atau operator langka dapat membutuhkan penyesuaian.
- Baca peringatan pengalihan ke CPU. Model dapat berjalan lancar di layar tetapi sebagian pekerjaannya ternyata dikerjakan CPU.
- Bandingkan biaya per pekerjaan. Harga per jam chip tidak sama dengan biaya menyelesaikan satu pelatihan. Ukur waktu dan biaya total untuk beban kerja yang sama di GPU dan Trainium.
- Periksa wilayah dan lokasi data. Sumber peluncuran tidak merinci wilayah AWS yang menyediakan Trainium. Pastikan ketersediaan dan aturan penempatan data sesuai kebijakan organisasi, termasuk ketentuan pelindungan data pribadi.
- Waspadai ketergantungan baru. Kode model tetap PyTorch standar, tetapi kernel NKI hanya berjalan di Trainium. Semakin banyak kernel khusus yang ditulis, semakin besar biaya berpindah lagi.
Organisasi yang belum memiliki tim ML sendiri tidak perlu terburu-buru. Pada tahap beta, pilihan chip biasanya mengikuti beban kerja yang sudah ada. Merakit membantu organisasi memetakan beban kerja tersebut lewat layanan machine learning, cloud computing, dan kecerdasan buatan.
Pertanyaan yang sering muncul
Apa itu TorchNeuron?
TorchNeuron adalah backend PyTorch sumber terbuka dari Amazon yang mendaftarkan chip Trainium sebagai perangkat neuron. Dengan begitu, model PyTorch dapat berjalan di Trainium2 dan Trainium3 memakai fungsi PyTorch yang sudah dikenal.
Apakah kode PyTorch langsung berjalan tanpa perubahan?
Untuk kasus sederhana, Amazon menyebut cukup mengganti pengaturan perangkat. Pada praktiknya rilis beta ini belum mendukung bentuk input dinamis dan beberapa operator, dan performa produksi biasanya memerlukan torch.compile. Cartesia sendiri melaporkan perubahan yang minimal pada kodenya, tetapi tidak nol.
Apakah TorchNeuron gratis dan chip mana yang didukung?
Perangkat lunaknya gratis dan berlisensi Apache 2.0, serta mendukung Trainium2 dan Trainium3. Biaya penyewaan chip Trainium di AWS tetap berlaku, dan sumber peluncuran tidak membahas harganya.
Penutup
TorchNeuron menurunkan hambatan teknis untuk mencoba chip Trainium, tetapi hasil nyatanya baru terlihat setelah banyak tim mengujinya dengan model sendiri. Mulailah dari satu model, ukur hasilnya, dan putuskan berdasarkan data. Tim Merakit siap berdiskusi bila organisasi Anda ingin menyusun rencana uji coba tersebut.
Sumber
- Introducing TorchNeuron: Native PyTorch backend for AWS Trainium, PyTorch Blog (diperbarui 20 Oktober 2026)
- Amazon’s TorchNeuron lets PyTorch code run on AWS Trainium chips, The Next Web (19 Oktober 2026)
- TorchNeuron brings PyTorch code to AWS Trainium without modifications, Techzine (20 Oktober 2026)
- TorchNeuron untuk PyTorch di chip AWS Trainium, About Amazon (Oktober 2026)
- Dokumentasi AWS Neuron: PyTorch native overview